大规模跨节点专家并行 EP:545% 利润率背后的软件架构优化
《DeepSeek 原理与实践》第 15 篇:deepseek-V3/R1 架构设计思路。
开源周的最后一天,DeepSeek分享了DeepSeek-V3/R1的架构设计思路,让大家能够更系统更全面的了解其推理系统的设计过程,以及更深刻的理解之前开源的6个项目。
DeepSeek-V3/R1推理系统的核心目标是什么?
通过软件架构的优化,达到:
- 更高的吞吐量;
- 更低的延时;
为什么DeepSeek要走这一条路?
曾经AI技术发展,GPU就是瓶颈。
GPU是瓶颈的时候,有两条路可走:
其一,水平扩展scale out:囤卡,堆GPU;
其二,垂直扩展scale up:GPU升级换代;
但这两条路,都被死死的卡在漂亮国的手里。
卡,限制你,不让你囤。
先进的卡,不卖给你,谁叫你落后5年。
为了突破瓶颈,DeepSeek被逼无奈的走出了第三条路:通过软件优化架构优化。
为了达成目标,DeepSeek的核心方案是啥?
大规模的跨节点专家并行EP,Expert Parallelism。
通过提升专家并行EP的数量(batch size),提升GPU矩阵乘法的效率,提高吞吐;与此同时,多专家分散在不同的GPU,每个GPU只需要计算更少的专家,访问更少的数据,从而降低延迟。
大规模的跨节点专家并行EP,会对软件架构带来什么新的挑战?
- EP跨节点传输,要解决传输与计算并行的问题;
- EP多节点联动,要解决数据分发汇总,负载均衡等问题;
大规模的跨节点专家并行EP的部署与策略是怎么样的?
由于V3/R1的专家数量众多,并且每层256个专家中仅激活其中8个,DeepSeek采用多机多卡间的专家并行策略来达到以下目的:
Prefill预填充阶段:路由专家EP-32、MLA和共享专家DP-32,一个部署单元是4节点,32个冗余路由专家,每张卡9个路由专家和1个共享专家;
Decode解码阶段:路由专家EP-144、MLA和共享专家DP-144,一个部署单元是18节点,32个冗余路由专家,每张卡2个路由专家和1个共享专家;
这两个阶段的负载均衡策略各不相同。
如何解决计算与传输并行的问题?
多机多卡的专家并行会引入比较大的通信开销,所以DeepSeek使用双向通道,提高整体吞吐。
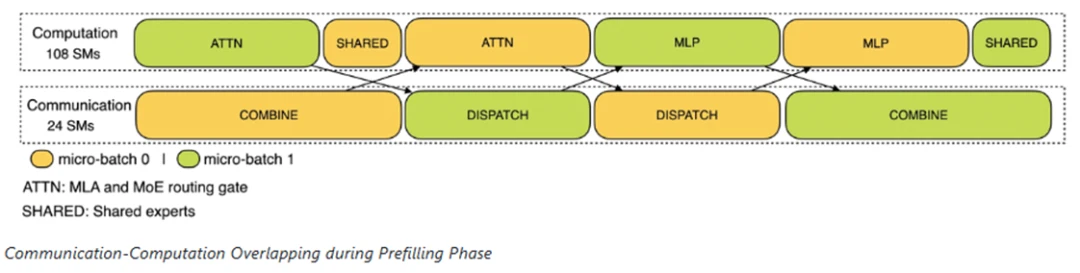
预填充阶段:计算和通信交错进行,一个通道计算的时候,另一个通道通信。
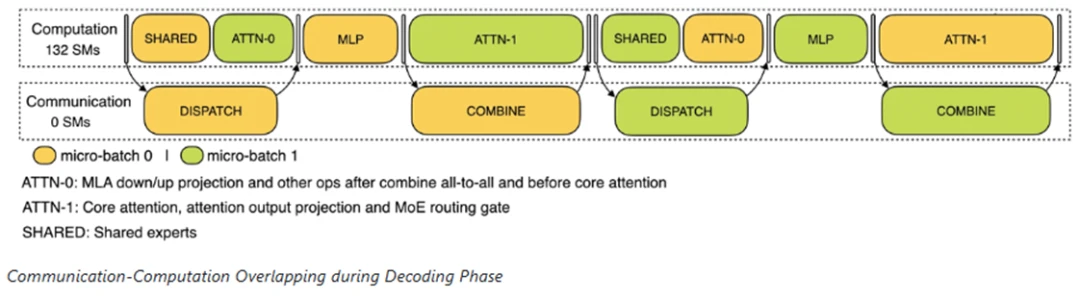
解码阶段类似:计算与通讯交错进行,通过流水线来实现计算和通信的重叠。
如何最大程度的负载均衡?
由于采用了很大规模的数据并行与专家并行,如果某个GPU的计算或通信负载过重,单个长尾将成为整个系统的瓶颈。与此同时其他GPU因为等待而空转,造成整体资源利用率下降。因此必须尽可能地为每个GPU平均分配计算负载、通信负载。
预填充阶段(prefilling stage):
- 专家组分配到节点,保证节点负载均衡;
- 节点内复制专家;
- 专家分配到GPUs,保证GPUs负载均衡;
解码阶段(decoding stage):
- 全局复制专家,不管专家在哪个组;
- 专家分配到GPUs,保证GPUs负载均衡;
总而言之,保证负载均衡,充分发挥GPUs的潜力,提升训练效率,缩短训练时间。
其整体架构如下:
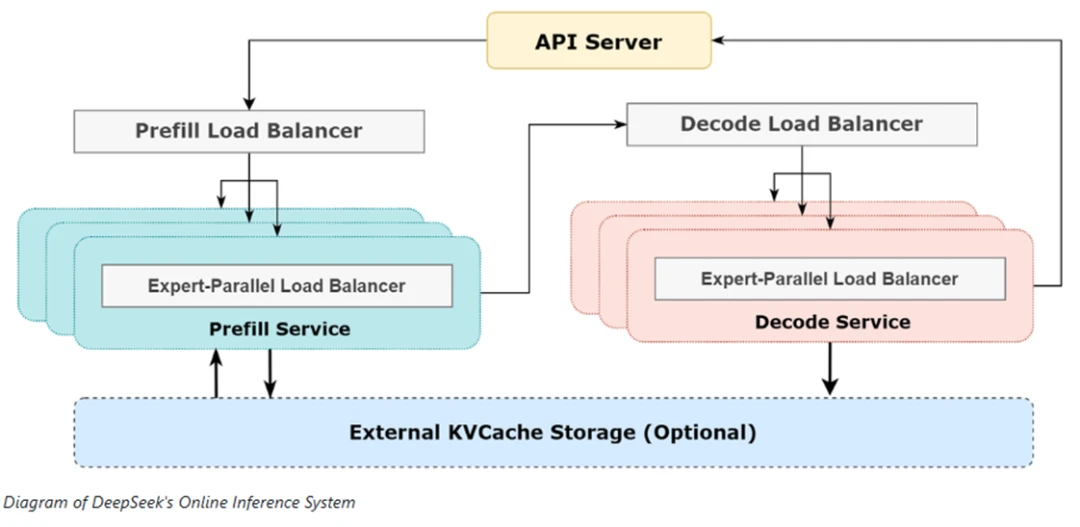
V3/R1的所有GPU均使用H800 GPU:
- 矩阵计算,分发:采用FP8格式;
- 核心注意力计算,合并:采用BF16格式;
同时兼顾效率与质量。
另外,由于白天的服务负荷高,晚上的服务负荷低,因此DeepSeek实现了一套机制:
- 在白天负荷高的时候,所有节点部署推理服务;
- 晚上负荷低的时候,减少推理节点,以用来做研究和训练;
综上所述,如果所有tokens全部按照R1的定价计算,理论上DeepSeek一天的总收入为$562,027,成本利润率545%。
到这里,DeepSeek开源周的所有7个项目就写完了,最后再来个汇总:
- DeepSeek 开源拆解:FlashMLA(9/16)
- DeepSeek 开源拆解:DeepEP(10/16)
- DeepSeek 开源拆解:DeepGEMM(11/16)
- DeepSeek 开源拆解:DualPipe(12/16)
- DeepSeek 开源拆解:EPLB(13/16)
- DeepSeek 开源拆解:3FS(14/16)
- 《V3/R1架构设计思路(本文)》
检验一下
想深挖一层,直接去官方仓库翻代码:github.com/deepseek-ai,所有项目细节,git 可查。
开源周的 7 个项目全部在这里——配合本篇的架构思路回头看,每个项目卡在系统的哪个位置就清楚了。
开源周 7 个项目讲完了,但故事还有最后一环:这些项目背后,幻方到底押注了哪三大核心技术?下一篇,也是本系列最后一篇,一次说透。
知其然,知其所以然。思路比结论更重要。