一个文件系统而已?任何脱离业务的架构设计都是耍流氓
《DeepSeek 原理与实践》第 14 篇:deepseek 极限潜能 – 3FS。
有人说,deepseek一个搞AI的公司,不干正事,开源一个文件系统,有啥值得吹的。今天来简单聊聊3FS,包懂。
3FS是什么?
3FS,Fire-Flyer File System,是一个用C++写的高性能分布式文件系统。
幻方官网给出的翻译是“萤火”。
deepseek为什么要重写分布式文件系统?
主要两个原因。
其一,技术已经全面升级。
- 传统的分布式文件系统设计之初基本,大部分基本基于HDD与NFS TCP/IP;
- 而AI训练与推理大范围使用SSD与RDMA;
RDMA,Remote Direct Memory Access ,远程直接内存访问,最新高性能网络通讯技术。
其二,AI训练与推理的业务需求传统分布式文件系统已经难以满足。
- 海量数据顺序读(语料输入);
- 检查点(分步骤重算);
- 顺序写(模型参数保存);
- 随机读(特征查询);
任何脱离业务的架构设计都是耍流氓。Deepseek说,已有的分布式文件系统无法满足我的需求时,我就自己重写一个。
如何重写一个分布式文件系统?
核心架构选型,基本是两条路。
其一,重写Linux内核的文件管理模块。
这条路似乎走不通:
- 不能使用C++ STL等成熟库;
- 不能使用用户态下的编译,调试工具(例如:Valgrind);
额,最烦用Valgrind查内存泄露。
- 要考虑大量的兼容性;
- 编译,测试周期长;
- 容易导致系统崩溃;
…
还有很重要的一点,deepseek没有搞Linux内核编程的人。
其二,正好Linux提供了FUSE机制,允许用户在不修改内核代码的情况下,在用户空间实现自己的文件系统。
FUSE,Filesystem in Userspace,允许用户通过接口与Linux虚拟文件系统VFS对接。
这样的话,deepseek就能用高效的语言,高效的工具,高效的开发适配自己业务的分布式系统了。
这里,除了说一声deepseek流弊,也让我们大声喊出:Linux流弊!
作为一个分布式文件系统,3FS有哪些特点?
- 高性能:所有组件都采用RDMA网络连接,零拷贝。
- 低耦合:元数据与存储分离。
额,分布式文件系统一般都这么搞,不值得吹。
- 一致性:基于FoundationDB不同场景支持不同的一致性模型:
常规写入:强一致,链式复制;
文件更新:最终一致,定期同步;
很少有文件系统这么搞,这是一个一致性与性能的折衷。
- 均衡性:智能数据分片;
- 可靠性:多副本。
额,分布式文件系统一般都这么搞。
- 灵活性:物理块大小分级,从64K到64M,适配不同AI训练与推理场景。
减少了碎片,提高了SSD效率,但需要维护更多层级的资源池,分配复杂度提升。这是一个存储效率与存储复杂度的折衷。
- 快速恢复:全量替换。
额,这是一个偷懒的设计,不用复杂的回放恢复,简化了恢复流程,数据恢复期间比较占流量。往好的方面吹,只能说恢复速度快了=_=。或者这么说,文件损坏是小概率事件,不值得因此把整体设计搞复杂,这是一个概率与复杂性的折衷。
总的来说,针对AI训练与推理的场景,3FS做了非常多针对性的优化。
代码还在看,看完再和大家细致交流。
最终3FS达到了什么效果?
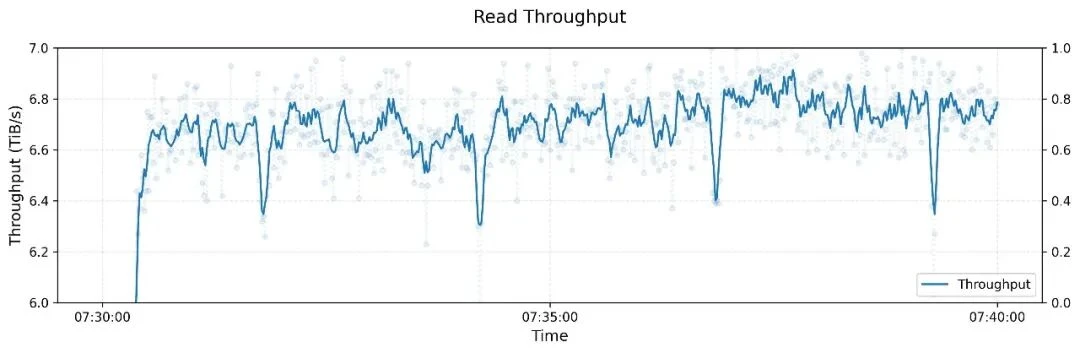
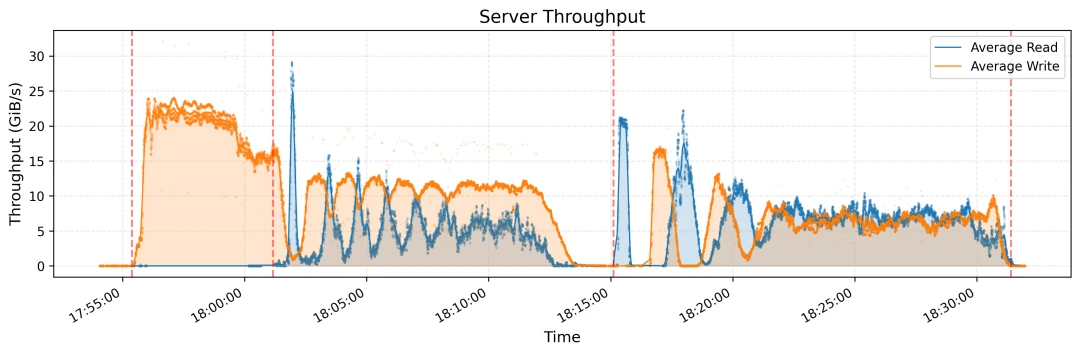
上面是3FS官网git给出的数据,并附上了实验复现步骤。
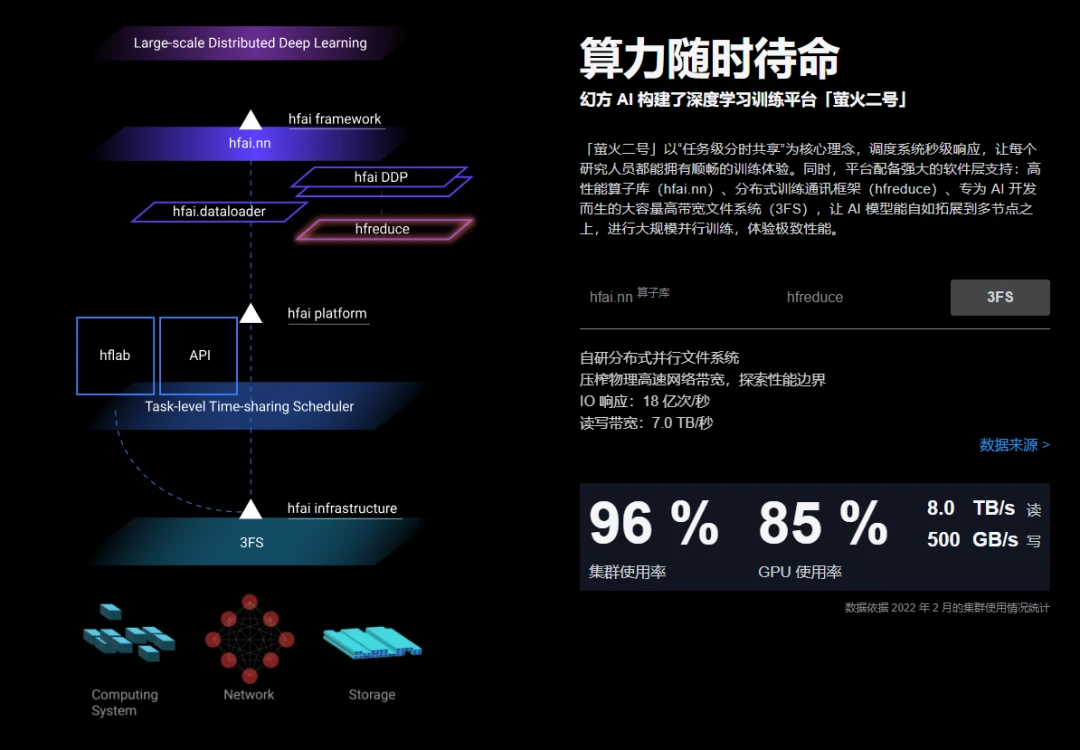
幻方官网,最显著的位置,说明了3FS是他们最大的三大核心竞争力之一。
还有算子库+分布式训练通讯框架。
读:8T/s
写:500G/s
IO响应:18亿次/s
集群使用率:96%
GPU使用率:85%
看到这里,你还会说,“一个文件系统而已”了吗?
检验一下
想深挖一层,读官方仓库与官方博客:github.com/deepseek-ai/3FS、high-flyer.cn/blog/3fs,数据与复现步骤都在里面。
来自官方 git 与官方 blog,可参考——读 8T/s、写 500G/s、IO 响应 18 亿次/s 的实验复现步骤就附在仓库里。
文件系统只是底座。底座之上,V3/R1 的推理系统是怎么把 545% 的成本利润率算出来的?下一篇,拆 DeepSeek-V3/R1 的架构设计思路。
知其然,知其所以然。思路比结论更重要。