为混合专家 MOE 与并行专家 EP 量身定制的通信库:降低延时,提升吞吐量
《DeepSeek 原理与实践》第 10 篇:deepseek 极限潜能 – DeepEP。
deepseek开源周,继Flash-MLA之后,开源了第二弹DeepEP。
画外音:上一顿还没消化完,新的大餐又来了。
今天简单聊聊:
1. 吃瓜:DeepEP是干嘛的?
2. 技术:DeepEP是怎么做到的?
3. 普通人有什么用:对写提示词有什么启示?
DeepEP是干嘛的?
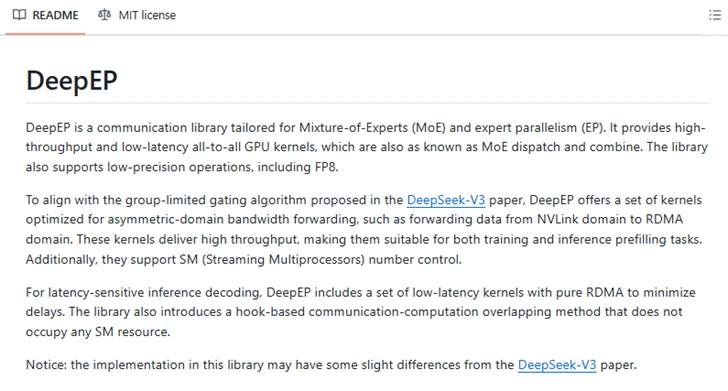
DeepEP,Distributed Expert Parallel Communication Library,是为混合专家MOE与并行专家EP量身定制(tailored)的通信库(communication library)。
DeepEP通讯库能达到什么效果?
- 降低延时;
- 提升吞吐量;
其背后就是:训练/计算更快,成本更低,模型迭代更快。
它是怎么做到的?
核心思路:优化MOE混合专家节点间的数据分发与合并。
什么是混合专家MOE?
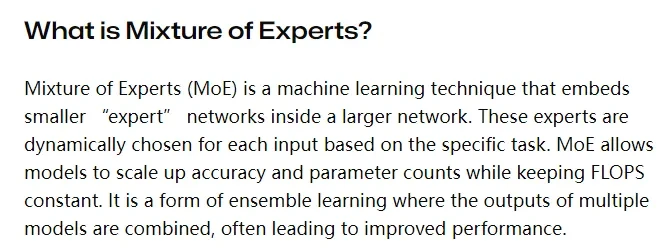
混合专家,Mixture of Experts,该模型思路不再追求大而全,转而追求多而专精。它会将任务动态路由给各个领域专家,并将各个领域专家的输出进行组合。
举个容易理解的例子。
大而全模型:全栈工程师。
混合专家模型:Java,FE,QA,DBA,OP工程师…
有了MOE之后,对LLM的架构有什么影响?
学习与训练阶段
之前:追求多参数
如今:训练多专家Expert(例如:1万个专家,每个专家单一职责SRP)
计算与执行阶段
之前:收到提示词input,一上来就干
如今:
- 先判断,需要几个专家(分类任务,很容易);
- 动态路由(需要一个门控网络作为协调者,Gating Network),分发任务给专家,专家并行计算;
- 组合专家输出, 协调者再统筹输出;
新的模式,不管是训练阶段还是执行阶段,专家节点之间都需要进行大量的通讯,而DeepEP就好比节点间的智能物流:
1. NVLink优化,好比建成城际高铁,负责同一节点内专家高速通讯,交换数据,带宽高达160GB/s,接近硬件极限;
2. RDMA优化,好比建成跨城磁悬浮,负责跨节点专家高速通讯,跨节点直接访问内存,带宽高达50GB/s;
3. FP8优化,低精度运算,好比货物压缩,更省空间,能交换更多信息;
这些优化对deepseek非常的重要:
专家分发(Dispatch):数据快速精准分配给多个专家;
数据合并(Combine):汇总各个专家的处理结果,统筹形成最终数据;
对我们普通人写提示词有什么启示?
为了充分发挥deepseek的混合专家MOE的最大潜力,可以显性告诉它,你希望它扮演哪些专家角色来回复问题。
bad case:如何设计高并发高可用系统?
这样的提示词,你会得到一个泛泛而谈的回答。
good case:假设你是由以下专家组成的团队:
- 分布式领域系统架构师
- 电商领域业务架构师
- 资深DBA
请分别从各自领域提出5项技术选型建议,并组合设计方案满足每秒10万次交易,数据满足最终一致性,故障恢复时间小于30秒的系统。
没错,你不止可以让deepseek扮演一个角色,你甚至可以让他扮演专家团的多个角色。此时处理时间并不会显著增长,但输出质量会显著提高。
节省训练资源,缩短回复时间,提升回答质量,多个专家还能够交叉验证(大而全模型可能过拟合),deepseek创新性使用MOE之后,很快就得到了业界的广泛认可与复制。
稍作总结
1. DeepEP,是为混合专家MOE量身定制的通信库;
2. DeepEP的核心思路是:优化MOE混合专家节点间的数据分发与合并;
3. 提示词层面:通过让deepseek显性扮演专家团的多个角色,能充分发挥deepseek的混合专家MOE机制,不会显著增加处理时间,但能显著提升输出质量;
一切的一切,提示词只有适配了AI的认知模式,才能最高效的发挥最大的作用。
检验一下
想深挖一层,直接去官方仓库翻代码:github.com/deepseek-ai/DeepEP,可参考。
本篇提到的 NVLink、RDMA、FP8 三大优化和 Dispatch/Combine 的细节,仓库 README 里有一手说明。
DeepEP 解决了专家之间的通讯问题,那专家手里算的「矩阵乘法」本身呢?——第 11 篇,我们拆 DeepGEMM,看 300 行代码怎么把 FP8 矩阵乘法做到极致。
知其然,知其所以然。思路比结论更重要。