6 天,7 个项目:我学 DeepSeek 这一个月的全局地图
DeepSeek 开源周,6 天,7 个项目。
最近一个月,给了自己一个深入了解 DeepSeek 的机会,汇总记录如下:用通俗易懂的话,讲述 DeepSeek 开源的那些项目。
2 月 24 日:FlashMLA
一个高性能显卡定制的”AI 加速工具”,加速到什么程度?
- 处理速度达到 3000GB/s;
- 算力达到 580 万亿次/s;
2 月 25 日:DeepEP
为混合专家 MOE与并行专家 EP量身定制的通讯库,能达到什么效果?
- 降低延时;
- 提升吞吐量;
训练/计算更快,成本更低,模型迭代更快。
2 月 26 日:DeepGEMM
一个 FP8 通用矩阵乘法库(library),300 行优美的代码,效率提高 N 倍。
2 月 27 日:DualPipe
一个双向管道并行算法,提高了前向传播/反向传播过程中的计算+通信效率,降低了单向流水线的等待时间,作者之中:
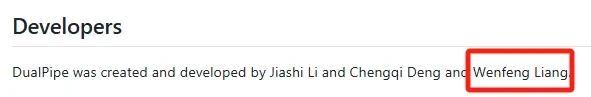
梁文锋赫然在列!
2 月 27 日:EPLB
一个动态负载均衡算法,在使用专家并行 EP 时,不同专家会被分配到不同的 GPU,EPLB 保证了 GPU 负载的均衡。
分级,冗余,就近,动态… 工程架构领域,哪有什么新鲜事,可偏偏在 deepseek 手里大放异彩。
2 月 28 日:3FS
一个用 C++ 写的高性能分布式文件系统,幻方官网,最显著的位置,说明了 3FS 是他们最大的三大核心竞争力之一。
它流弊到什么程度?
读:8T/s
写:500G/s
IO 响应:18 亿次/s
集群使用率:96%
GPU 使用率:85%
2 月 29 日:V3/R1 整体架构思路
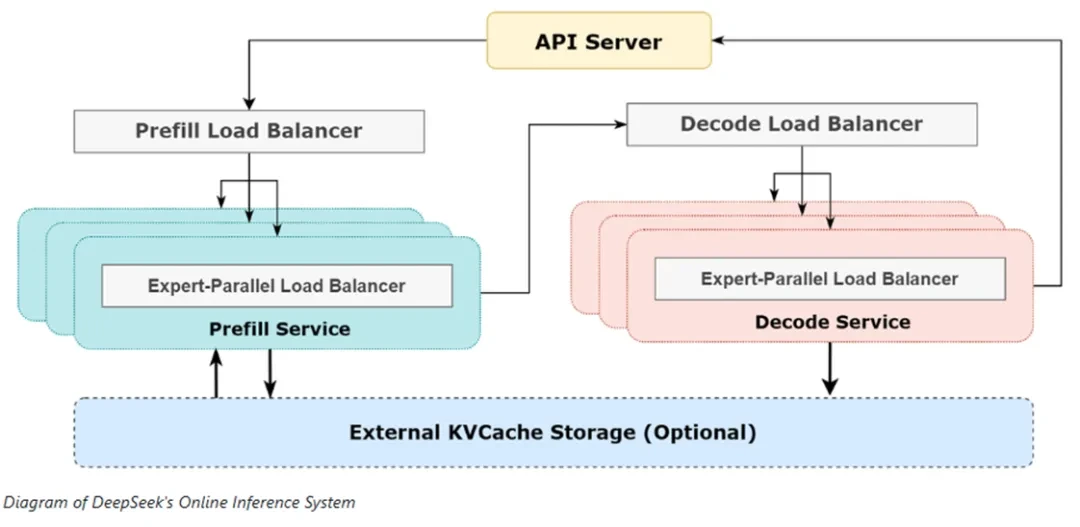
V3/R1 软件优化架构优化。
为什么 DeepSeek 要走这一条路?
GPU 是瓶颈的时候,有两条路可走:
其一,水平扩展 scale out:囤卡,堆 GPU;
其二,垂直扩展 scale up:GPU 升级换代;
但这两条路,都被死死的卡在漂亮国的手里。
卡,限制你,不让你囤。
先进的卡,不卖给你,谁叫你落后 5 年。
为了突破瓶颈,DeepSeek 被逼无奈的走出了第三条路:通过软件优化架构优化。
想深挖一层,直接去官方仓库翻代码:github.com/deepseek-ai,所有项目细节,git 可查。
这个系列的第 9-16 篇,就是把上面每个项目逐个拆开讲——汇总看不懂没关系,后面的拆解篇会一个一个讲透。
DeepSeek 开源一周,自己学了一个月。在这期间,收获最大的人,一定是我自己。
世界上从来就没有什么腾空出世:
to DeepSeek!
to 我自己!
共勉!
这份汇总里的每个项目,这个系列后面都有单独一篇展开。但我们从头开始——第 1 篇,先讲怎么向 deepseek 提问:达到最佳效果的 3 大原则。
知其然,知其所以然。思路比结论更重要。