drop、truncate、delete 的五点差异,和自增 ID 不复位的大坑
《数据库内核原理》第 36 篇:删除数据的三种方式。
行数据批量delete时,InnoDB如何处理自增ID的?
这里有一个潜在的大坑。
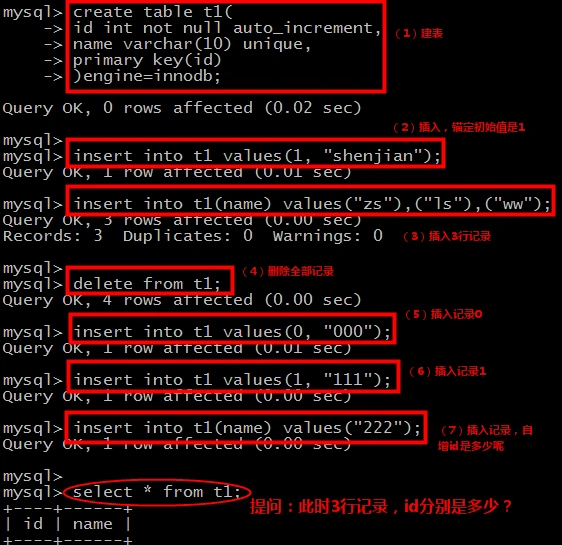
整个实验步骤如上图:
建表,设定自增列
指定id=1插入,锚定第一行的id是1
不指定id,依赖自增机制,插入3行
此时id应该变为2,3,4了?
delete删除所有记录
坑就容易出在这里。
指定id=0插入
指定id=1插入
不指定id,依赖自增机制,插入1行
请问,此时表中的三行记录,id分别是多少?
是否符合大家的预期?
今天花1分钟,说说使用truncate与delete批量删除数据的异同。
批量删除数据有三种常见的方法
drop table
当不需要该表时,可以使用该方法。
truncate table
删除所有数据,同时保留表,速度很快。
可以理解为,drop table然后再create table。
delete from table
可以删除所有数据,也能保留表,但性能较差。
也可以带where条件删除部分数据,灵活性强。
虽然truncate和delete都能够删除所有数据,且保留表,但它们之间是有明显差异的。
一、
truncate是DDL语句,它不存在所谓的“事务回滚”;
delete是DML语句,它执行完是可以rollback的。
二、
truncate table返回值是0;
delete from table返回值是被删除的行数。
三、
InnoDB支持一个表一个文件,此时:
truncate会一次性把表干掉,且不会激活触发器,速度非常快;
delete from table则会一行一行删除,会激活触发器,速度比较慢。
delete数据,是要记录日志的,truncate表不需要记录日志。
四、
当表中有列被其它表作为外键(foreign key)时:
truncate会失败;
delete则会成功。
这类数据删除失败很容易定位问题,因为报错提示简单易懂。
五、
当表中有自增列时:
truncate会使得自增列计数复原;
delete所有数据后,自增列计数并不会从头开始。
因此,delete所有数据后,自增列计数的这个行为,往往不是用户想要的,所以是一个潜在坑。
这一分钟,有收获吗?
请根据自己的业务场景,选择删除数据的方式哟。
作业题:
开篇的实验,最后三行记录,id分别是多少?
讲了半天,奈何还是答不对。
检验一下
检索练习 · 三种方式怎么选
三种批量删除方式 drop table、truncate table、delete from table,各自的特点是什么?
检索练习 · 事务与返回值
truncate 和 delete 在「事务回滚」与「返回值」上的差异是?
检索练习 · 触发器与速度
InnoDB 一个表一个文件时,为什么 truncate 比 delete 快得多?
检索练习 · 自增列的坑
表中有自增列时,delete 删除所有数据后再插入,自增 ID 会怎样?
删除聊完,聊聊「大表怎么办」的另一种思路——分区表看上去很帅,互联网公司为什么不用?第 37 篇:互联网公司为什么不用 MySQL 分区表?
知其然,知其所以然。思路比结论更重要。