一致性不是主要矛盾时,冗余表怎么写、不一致了又怎么兜底
《数据库内核原理》第 35 篇:反范式与冗余表设计。
有水友问我说,学校学数据库,都讲究“范式设计”,为什么很多互联网公司数据库都搞“反范式”设计呢?
什么是数据库范式设计?
1NF:字段原子性;
2NF:所有字段必须依赖主键;
3NF:所有字段必须直接依赖主键;
为什么要搞数据库范式设计?
减少数据冗余,减少数据依赖,确保数据一致性与完整性。
为什么很多互联网公司数据库都搞“反范式”设计?
任何脱离业务的数据库设计都是耍流氓。
很多互联网业务场景,数据的一致性与完整性并不是主要矛盾,大数据量与高并发量才是瓶颈,针对这两个要素的设计才是核心,常见的典型“反范式”设计有:
1. 字段拆分,提升性能;
2. 放弃外键,减少JOIN,提升性能;
数据库范式设计,大量依赖JOIN。
3. 最终一致性,提升性能;
4. 放弃事务,牺牲一致性与完整性,提升性能;
5. 异步更新,牺牲一致性,提升性能;
6. 数据冗余,牺牲一致性,提升性能;
7…
特别是数据冗余,在大数据量与高并发量的数据库设计中使用极其广泛,今天重点讲讲冗余表的设计。
为什么会需要冗余表?
数据量很大的时候,数据库往往要进行水平切分,水平切分会有一个partition key,通过partition key的查询能够直接定位到库,但是非partition key上的查询可能就需要扫描多个库了。
例如订单表,业务上对用户和商家都有订单查询需求:
Order(oid, info_detail)
T(buyer_id, seller_id, oid)
如果用buyer_id来分库,seller_id的查询就需要扫描多库;如果用seller_id来分库,buyer_id的查询就需要扫描多库。
这类业务“高吞吐量低延时”的查询需求,往往是通过“数据冗余”的方式来满足的,就是所谓的“冗余表”:
T1(buyer_id, seller_id, oid)
T2(seller_id, buyer_id, oid)
同一个数据,冗余两份,一份以buyer_id来分库,满足买家的查询需求;一份以seller_id来分库,满足卖家的查询需求。
冗余表如何实现?
常见的方案有三种。
方案一:服务同步写法
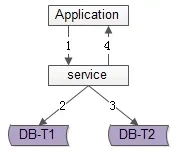
顾名思义,由服务层同步写冗余数据:
1. 业务方调用服务,新增数据;
2. 服务先插入T1数据;
3. 服务再插入T2数据;
4. 服务返回业务方新增数据成功;
优点:
1. 不复杂,服务层由单次写,变两次写;
2. 双写成功才返回,数据一致性相对较高;
缺点:
1. 要插入两次,请求的处理时间增加;
2. 数据仍可能不一致,写入T1完成后服务重启,则数据不会写入T2;
如果系统对处理时间比较敏感,引出常用的第二种方案。
方案二:服务异步写法
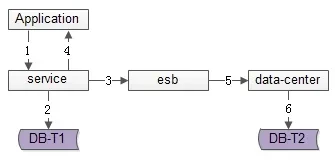
数据的双写并不再由服务来完成,服务层异步发出一个消息,通过MQ发送给一个专门的数据复制服务来写入冗余数据,如上图1-6流程:
1…
2. 服务先插入T1数据;
3. 服务向MQ发送一个异步消息;
…
6. 异步插入T2数据;
优点:服务只插入1次,请求处理时间短。
缺点:
1. 系统的复杂性增加了,多引入了两个新组件,MQ与异步服务;
2. 业务线返回成功时,数据还不一定异步插入到T2中,因此数据有一个不一致时间窗口,这个窗口很短,最终是一致的;
3. 在消息总线丢失消息时,冗余表数据仍可能不一致;
如果想解除“数据冗余”对系统的耦合,引出常用的第三种方案。
方案三:线下异步写法
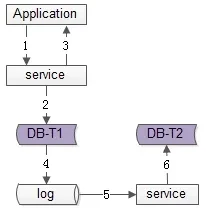
数据的双写不再由服务层来完成,而是由线下的一个服务或者任务来完成,最常见的,就是利用DTS这类异步数据同步服务,完成数据的冗余。
优点:
1. 数据双写与业务完全解耦;
2. 服务只插入1次,请求处理时间短;
缺点:
1. 业务线返回成功时,数据还不一定异步插入到T2中,因此数据有一个不一致时间窗口,这个窗口很短,最终是一致的;
2. 数据的一致性依赖于线下服务或者任务的可靠性;
可以看到,由于冗余表的插入不具备事务性,不管哪一种方案,都有可能出现T1插入成功,T2插入失败的情况,从而丧失“最终一致性”特性,那怎么办呢?
如何保证冗余表数据的最终一致性?
常见的有四种方案。
方案一:线下定期扫描正反冗余表全部数据
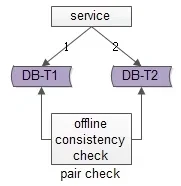
如上图所示,线下启动一个离线的扫描工具,不停地比对正表T1和反表T2,如果发现数据不一致,就进行补偿修复。
优点:
1. 比较简单,开发代价小;
2. 线上服务无需修改,修复工具与线上服务解耦;
缺点:
1. 扫描效率低,会扫描大量的“已经能够保证一致”的数据;
2. 由于扫描的数据量大,扫描一轮的时间比较长,即数据如果不一致,不一致的时间窗口比较长;
优化思路:定期扫描全量数据太低效,有没有一种只扫描“可能存在不一致可能性”的增量数据,以提高效率的优化方法呢?
方法二:线下扫描增量数据
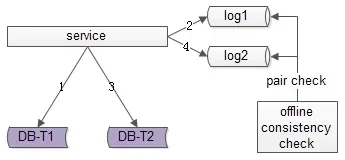
每次只扫描增量的日志数据,就能够极大提高效率,缩短数据不一致的时间窗口,如上图1-4流程所示:
1. 写入正表T1;
2. 写入日志log1;
3. 写入反表T2;
4. 写入日志log2;
然后通过一个离线的扫描工具,不停的比对日志log1和日志log2,如果发现数据不一致,就进行补偿修复。
优点:
1. 比较简单,开发代价小;
2. 数据扫描效率高,只扫描增量数据;
缺点:
1. 线上服务略有修改,但代价不高,多写了2条日志;
2. 虽然比方法一更实时,但时效性还是不高,不一致窗口取决于扫描的周期;
优化思路:有没有实时检测一致性并进行修复的方法呢?
方法三:实时线上“消息对”检测
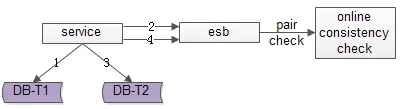
这次不是写日志了,而是向消息总线发送消息,如上图1-4流程所示:
1. 写入正表T1;
2. 发送消息msg1;
3. 写入反表T2;
4. 发送消息msg2;
正常情况下,msg1和msg2的接收时间应该在N秒以内,如不然,则进行补偿修复。
优点:效率高,实时性高。
缺点:相对复杂。
方案四:人工修复法
项目上线时间太紧,没时间搞一致性设计哇!
虽然插入不是原子的,奈何出现的概率低啊!
即使出现了,用户也不一定能发现呀!
用户发现了,找客服也不是找我呀!
找我,一个DBA工单就修复啦!
于是,大量的公司,不考虑正表和反表的数据一致性,事后发现,事后人工修复。
总结
1. 数据库范式设计,是为减少数据冗余,减少数据依赖,确保数据一致性与完整性而提出的;
2. 很多互联网业务场景,大数据量与高并发量才是瓶颈,故经常采用“数据冗余”这类反范式设计;
3. 数据冗余的常见方式有三种:
– 服务同步写
– 服务异步写
– 线下异步写
4. 修复冗余数据一致性的常见方案有四种:
– 线下定期扫全量
– 线下定期扫增量
– 线上实时“消息对”检测
– 躺平,人工修复
检验一下
检索练习 · 反范式动因
很多互联网公司数据库搞「反范式」设计的根本原因是什么?
检索练习 · 冗余表的目的
订单表对买家和商家都有查询需求,水平切分时用「冗余表」解决的是什么问题?
检索练习 · 三种冗余实现
冗余表的三种实现方案(服务同步写、服务异步写、线下异步写)共同存在的问题是?
检索练习 · 一致性兜底
四种修复冗余数据一致性的方案中,实时性最高的是哪一个?
设计聊完,回到操作——删除数据这件小事,也藏着坑。第 36 篇:MySQL 删除数据的三种方式,有什么坑?
知其然,知其所以然。思路比结论更重要。