专家并行的动态负载均衡:分级、冗余、就近、动态
《DeepSeek 原理与实践》第 13 篇:deepseek 极限潜能 – EPLB。
deepseek开源DualPipe的同一天,还开源了EPLB。今天来简单聊聊EPLB,包懂。
EPLB是干嘛的?
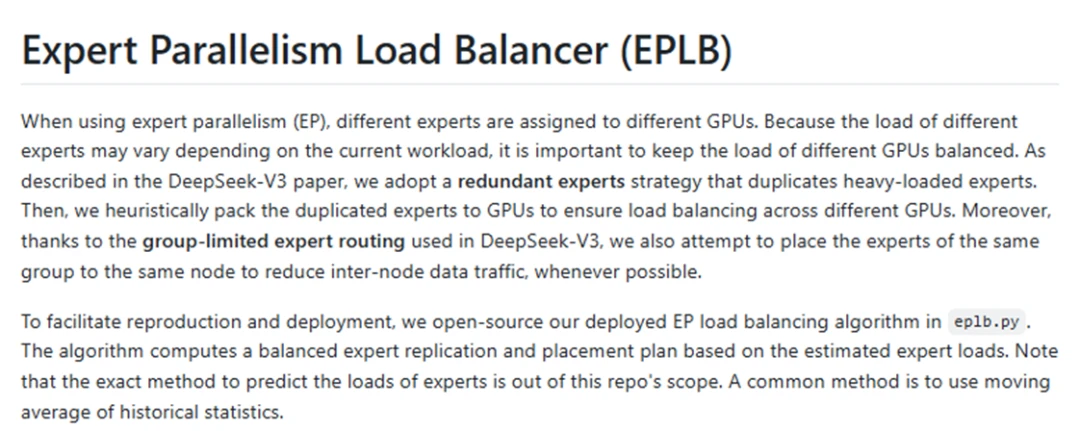
EPLB,Expert Parallelism Load Balancer,是一个动态负载均衡算法。
在使用专家并行EP时,不同专家会被分配到不同的GPU,而这些GPU的负载可能不均衡,此时就需要EPLB啦。
什么是专家并行EP?
专家并行EP,Expert Parallelism,是一种针对混合专家MOE设计的分布式并行技术。
什么是混合专家MOE?
混合专家MOE,Mixture of Experts,是deepseek大模型的核心创新应用,该模型思路不再追求大而全,转而追求多而专精。
关于混合专家MOE,详见:
《通俗讲解deepseek – MOE(3)》
混合专家MOE与专家并行EP,deepseek之前开源了其核心通讯库,详见:
EPLB是怎么做到负载均衡的?
EPLB像一个智能调度员,根据不同的场景调度专家进行计算,其负载均衡算法包含两类核心策略。
第一类:分级负载均衡。
使用场景:预填充阶段(prefilling stage),规模较小,服务器节点数(server nodes)能被专家组数(expert groups)整除的情况。
策略步骤:
- 专家组分配(pack to)到节点,保证节点负载均衡;
- 节点内复制专家;
- 专家分配到GPUs,保证GPUs负载均衡;
第二类:全局负载均衡。
使用场景:解码阶段(decoding stage),规模较大的情况。
策略步骤:
- 全局复制专家,不管专家在哪个组;
- 专家分配到GPUs,保证GPUs负载均衡;
总而言之,保证负载均衡,充分发挥GPUs的潜力,提升训练效率,缩短训练时间。
举个实际的例子?
DeepSeek-V3训练部署:
- 2048个NVIDIA H800;
- 256个服务器节点(每节点8GPU);
- 专家组数为64(EP-64);
接下来进行训练:
- 预填充阶段,一个专家组,例如Java+ FE+ QA+OP分配4个服务器节点,保证节点资源分配均衡;
- 专家冗余策略,当发现某个GPU负载超过阈值时,复制专家副本,分配到新的GPU。也就是说,Java成为项目瓶颈时,我们就组内复制多个Java;
- 原则上专家组之间避免全局通讯,而在有限节点内通讯,降低全局通讯压力;
画外音:全局通讯复杂度会指数级上升,只需要少量跨组协同。
- 解码阶段,需要大量QA工程师,这个时候切换为全局策略,忽略专家组物理拓扑限制,跨节点全局复制QA工程师,加速项目进度;
总的来说,几个核心设计思路:
- 分级调度策略:先节点均衡,再GPU均衡;
- 冗余专家策略:谁是瓶颈复制谁,保证均衡;
- 就近通讯策略:减少全局通讯;
- 动态切换策略:高峰期打破限制;
分级,冗余,就近,动态… 工程架构领域,哪有什么新鲜事,可偏偏在deepseek手里大放异彩。
一些启示
通过deepseek的一系列开源:
DeepSeek 开源拆解:DeepGEMM(11/16)》
DeepSeek 开源拆解:DualPipe(12/16)》
哪一个是惊世骇俗?
MLA:对显卡计算加速;
DeepEP:对通讯加速;
GEMM:对矩阵乘法加速;
DualPipe:对前向/反向传播加速;
EPLB:负载均衡充分利用资源;
3FS:文件系统加速(明天讲解);
…
世界上哪有什么腾空出世,deepseek的成功,完全出自一天天的脚踏实地,一天天的日积月累之中。
积跬步,至千里。
人的成功,也一样。
诸君共勉!
检验一下
想深挖一层,直接去官方仓库翻代码:github.com/deepseek-ai/EPLB,可参考。
本篇两类策略(分级/全局)的完整算法描述和 DeepSeek-V3 的部署参数(2048 张 H800、EP-64),仓库里都有第一手资料。
算得快、传得快、排得匀,最后一块拼图是数据本身:往哪儿存、怎么读得飞快?——第 14 篇,收尾讲 3FS,幻方三大核心竞争力之一的高性能分布式文件系统。
知其然,知其所以然。思路比结论更重要。