一份 2013 年的需求调研:四类 SQL 就够了,跨库 join 没人要
《数据库架构与实践》第 11 篇:数据库中间件不支持 join 的调研由来。
有网友对第 1 篇《数据库中间件,让你来设计,你会怎么设计?》一文中,数据库中间件仅仅支持四类SQL存有疑问:
partition key普通查询
partition key上的IN查询
非partition key上的查询
有限功能的排序+分页查询
这四类SQL就能满足公司业务的需求么,这个结论是怎么来的?
看来第 1 篇《数据库中间件,让你来设计,你会怎么设计?》的架构结论并不能让刨根究底的网友们满意,于是把13年底,需求调研的过程细节也说一说,作为一个一线架构师,治学还是得严谨。
业务侧的分库后SQL需求
先说结论,通过初步的调研,发现58各业务线对有分库需求的应用场景为:
partition key上的简单查询
WHERE key=xxx AND xxx
partition key上的IN查询
WHERE key IN(xxx, yyy) AND xxx
非partition key上的简单查询
WHERE notkey=xxx AND xxx
排序+分页的需求
ORDER BY xxx OFFSET xxx LIMIT xxx
大部分需求集中在前三条,排序+分页的需求由于分布式实现困难,各业务线往往也采用了一些限制或者变通手段实现,例如:
建立索引表以避免遍历库再内部排序
使用额外的id查询条件来避免大数据量的查询
调研结果显示,各业务线暂没有下列需求:
跨库join
跨库事务
跨库子查询
其他奇形怪状的SQL
搜索研发部调研
从搜索研发部高级架构师@longc 处了解到,暂时没有数据库分库需求。
@龙神 做搜索内核,压根瞧不起我这个用MySQL搞业务的人呀。
即时通讯部调研
和@sunx 进行了沟通,帮帮技术部没有水平分库,只有水平分表,业务需求为常见需求中的“partition key上的普通查询”。
对于58帮帮的“用户登录表”,数据量较大,目前分为32个表,以uid作为partition key,所有的查询都会带上partition key,故可以直接定位到数据所属的partition。
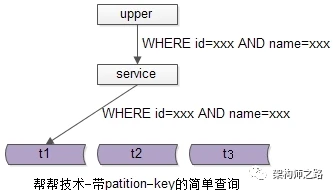
如上例,假设58帮帮对某数据量较大的表以id为partition key分了3个表,上游的所有查询都会带上id=xxx这个查询条件(当然,亦可以同时带上其他查询条件)。
@玄姐 设计的系统,架构考虑得极其完善。
移动研发部调研
从@liunz 了解到,无线分库使用场景和帮帮技术部类似,都是“partition key 上的普通查询”。
架构部调研
从@liuzw 了解到,架构部在imc,umc等服务使用水平分库,业务需求为常见需求中的“partition key 上的普通查询”,“partition key上的IN查询”,“非partition key上的查询”。
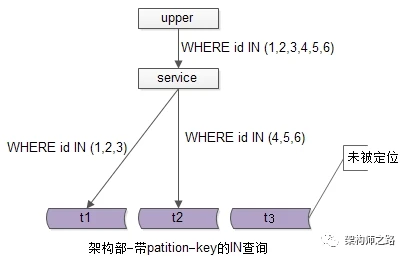
对于“partition key上的IN查询”,架构部采用的是将各个partition key定位到相关的库,最后将查询结果集汇总,再返回上游的方式来实现。注意,如上图所示,带partition key的IN查询并不一定会遍历所有的库。
对于“非partition key上的查询”,根据不同的业务,架构部有两种处理方式:
方式一
业务方不需要精确数据,随机取一个库的数据,即可满足业务方要求,例如“查询10个有头像的用户”
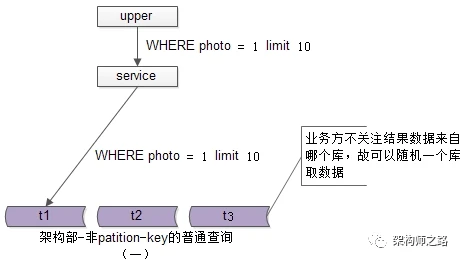
当业务方不需要关注结果集的精确性时,可以随机取一个库查询。
这是一个很好的设计,典型的“根据业务需求确定技术方案”的good case。
方式二
业务方需要精确数据,就必须遍历所有的库,例如“查询用户名为shenjian的用户”。
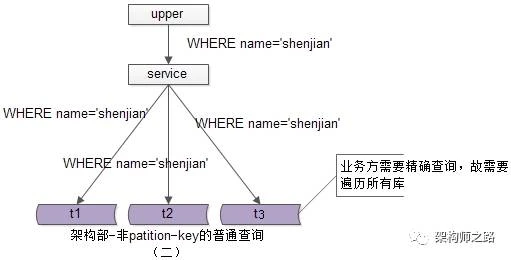
uid的生成没有采用“基因法”,非常遗憾。关于“基因法”的方案详见第 4 篇《数据库水平切分:单 KEY 业务(用户中心)》。
会员技术部调研
从@wangzt 了解到,会员技术部使用水平分库,调研结论里对分库的四种SQL需求在业务中都有用到。
对“非partition key上的查询”,除了使用架构部使用的全库查询方案,会员技术部还使用了冗余数据法来解决这个问题:
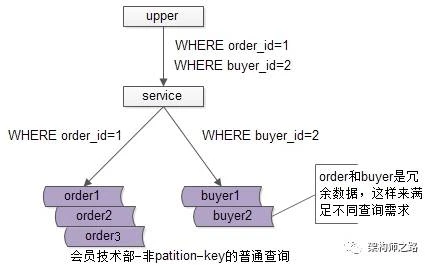
这种查询方式使用冗余数据来避免全库查询,缺点是可能存在数据一致性问题。
“跨库分页查询”,会员技术部的处理方式是索引表:
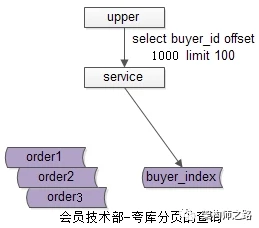
使用订单分库,买家的查询索引表,索引表的本质也是冗余。
关于“帖子业务的水平切分”的方案详见第 5 篇《数据库水平切分:一对多业务(帖子中心)》。
支付平台部调研
从@hudp 了解到,分库的数据访问,货币系统部所有的线上实时业务都必须携带partition key,故其访问模式和即时通讯的数据访问模式相同。
但对于支撑系统/统计需求,在分库数据上,他们计划引入cobar来解决他们的问题。
前端业务部调研
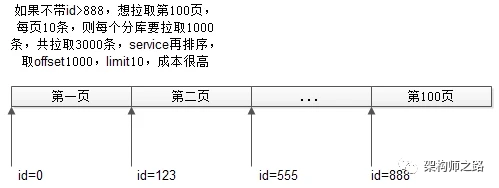
从@wangjk 了解到,前端业务部这边,四种分库SQL都有,对于跨库分页,前端业务部这边的业务上要求必须带上一个特殊的id作为where字段,以避免拉取大量的数据重新排序。
结论
58如果要做数据库中间件,一期支持四类SQL:
partition key普通查询
partition key上的IN查询
非partition key上的查询
有限功能的排序+分页查询
能够满足业务线绝大部分分库的需求。
一切脱离业务的架构设计,都是耍流氓。
做技术要严谨,除了上述需求调研,也做了充分的技术调研:
《数据库中间件mysql-proxy调研笔记》
才有了后来的概要设计:
末了:看到调研文档里熟悉的名字,眼泪不知不觉的流下来,兄弟们,你们还好吗?
检验一下
检索练习 · 四类 SQL
调研结论是:58 如果要做数据库中间件,一期只需支持哪四类 SQL?
检索练习 · 没有的需求
调研结果显示,各业务线暂没有下列哪些需求?
检索练习 · 非 partition key 查询
对于「非 partition key 上的查询」,架构部的两种处理方式是什么?
检索练习 · 冗余与索引表
会员技术部用「冗余数据法」避免全库查询,其缺点是什么?对「跨库分页查询」又采用什么方案?
需求调研之外还有技术调研。下一站先看阿里开源的服务端中间件——第 12 篇《数据库中间件 cobar 调研笔记》。
知其然,知其所以然。思路比结论更重要。