2013 年调研笔记:淘宝客户端中间件 TDDL,SQL 支持、三层结构与最佳实践
《数据库架构与实践》第 13 篇:TDDL 调研笔记。
前篇:
13年底负责数据库中间件设计时的调研笔记,拿出来和大家分享,轻拍。
TDDL是什么
TDDL是Taobao Distribute Data Layer的简称
淘宝一个基于客户端的数据库中间件产品
基于JDBC规范,没有server,以client-jar的形式存在
数据库中间件有基于服务端的,也有基于客户端的,TDDL属于后者;而cobar是一个中间层服务,使用mysql协议,属于前者。
TDDL不支持什么SQL
不支持各类join
不支持多表查询
不支持between/and
不支持not(除了支持not like)
不支持comment,即注释
不支持for update
不支持group by中having后面出现聚集函数
不支持force index
不支持mysql独有的大部分函数
分布式数据库中间件,join都是很难支持的,cobar号称的对join的支持即有限,又低效。
TDDL支持什么SQL
支持CRUD基本语法
支持as
支持表名限定,即”table_name.column”
支持like/not like
支持limit,即mysql的分页语法
支持in
支持嵌套查询,由于不支持多表,只支持单表的嵌套查询
分布式数据库中间件,支持的语法都很有限,但对于互联网的大数据/高并发应用,足够了,服务层应该做更多的事情。
TDDL其他特性
支持oracle和mysql
支持主备动态切换
支持带权重的读写分离
支持分库分表
支持主键生成:oracle用sequence来生成,mysql则需要建立一个用于生成id的表
支持单库事务,不支持跨库事务
支持多库多表分页查询,但会随着翻页,性能降低
可以看到,其实TDDL很多东西都不支持,那么为什么它还如此流行呢?它解决的根本痛点是“分布式”“分库分表”等。
加入了解决“分布式”“分库分表”的中间件后,SQL功能必然受限,但是,我们应该考虑到:MYSQL的CPU和MEM都是非常珍贵的,我们应该将MYSQL从复杂的计算(事务,JOIN,子查询,存储过程,视图,用户自定义函数)中释放解脱出来,将这些计算迁移到服务层。
当然,有些后台系统或者支撑系统,数据量小或者请求量小,没有“分布式”的需求,为了简化业务逻辑,写了一些复杂的SQL语句,利用了MYSQL的功能,这类系统并不是分布式数据库中间件的潜在用户,也不可能强行让这些系统放弃便利,使用中间件。
TDDL层次结构
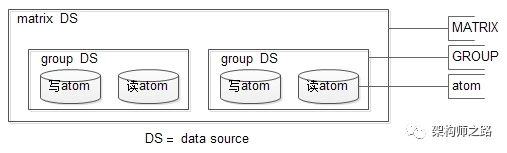
TDDL是一个客户端jar,它的结构分为三层:
层次
说明
其他
matrix
可以理解为数据源的全部,它由多个group组成
group
可以理解为一个分组,它由多个atom组成
atom
可以理解为一个数据库,可能是读库,也可能是写库
对应上面图例:matrix数据水平分为了两个group,每个group有主备atom组成。
matrix层
核心是规则引擎
实现分库分表
主要路径:sql解析 => 规则引擎计算(路由) => 执行 => 合并结果
group层
读写分离
权重计算
写HA切换
读HA切换
动态新增slave(atom)节点
atom层
单个数据库的抽象;
ip /port /user /passwd /connection 动态修改,动态化jboss数据源
thread count(线程计数):try catch模式,保护业务处理线程
动态阻止某些sql的执行
执行次数的统计和限制
整个SQL执行过程
BEGIN(sql+args),输入是sql和参数
sql解析
规则计算
表名替换
选择groupDS执行sql
根据权重选择atomDS
具备重试策略的在atomDS执行sql
读写控制,并发控制,执行sql,返回结果
合并结果集
END(ResultSet),输出是结果集
感觉难点在SQL的解析上。
TDDL最佳实践
尽可能使用1对多规则中的1进行数据切分(partition key),例如“用户”就是一个简单好用的维度
买家卖家的多对多问题,使用数据增量复制的方式冗余数据,进行查询
利用表结构的冗余,减少走网络的次数,买家卖家都存储全部的数据
这里我展开一下这个使用场景。
以电商的买家卖家为例,业务方既有基于买家的查询需求,又有基于卖家的查询需求,但通常只能以一个维度进行数据的分库(partition),假设以买家分库, 那卖家的查询需求如何实现呢?
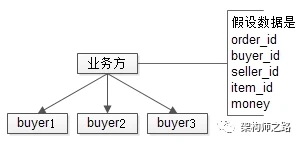
如上图所示:查询买家所有买到的订单及商品可以直接定位到某一个分库,但要查询卖家所有卖出的商品,业务方就必须遍历所有的买家库,然后对结果集进行合并,才能满足需求。
所谓的“数据增量复制”“表结构冗余”“减少网络次数”,是指所有的数据以买家卖家两个维度冗余存储两份,如下图:
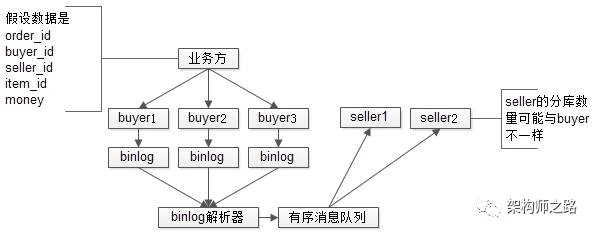
采用一个异步的消息队列机制,将数据以另一个维度增量复制一份,在查询的时候,可以直接以卖家直接定位到相应的分库。
这种方式有潜在的数据不一致问题。
继续tddl最佳实践:
利用单机资源:单机事务,单机join
存储模型尽量做到以下几点:
尽可能走内存
尽可能将业务要查询的数据物理上放在一起
通过数据冗余,减少网络次数
合理并行,提升响应时间
读瓶颈通过增加slave(atom)解决
写瓶颈通过切分+路由解决
相比数据库中间件内核,最佳实践与存储模型,对我们有更大的借鉴意义。
TDDL的未来?
kv是一切数据存取最基本的组成部分
存储节点少做一点,业务代码就要多做一点
想提升查询速度,只有冗余数据一条路可走
类结构化查询语言,对查询来说非常方便
潜台词是,在大数据量高并发下,SQL不是大势所趋,no-sql和定制化的协议+存储才是未来方向?
13年底的调研笔记,文中的“画外音”是我当时的批注,希望能让大家对TDDL能有一个初步的认识,有疑问之处,欢迎交流。
相关文章:
检验一下
检索练习 · TDDL 形态
TDDL 是什么形态的数据库中间件?和 cobar 的根本区别是什么?
检索练习 · 不支持与支持
下列哪组 SQL 能力是 TDDL 不支持的?
检索练习 · 三层结构
TDDL 的 matrix、group、atom 三层各自是什么?
检索练习 · 最佳实践
买家卖家的多对多查询问题,TDDL 最佳实践给出的方案是什么?潜在问题是什么?
服务端、客户端都看了,下一篇看 360 在官方 mysql-proxy 上改造出来的——第 14 篇《数据库中间件 Atlas 调研笔记》。
知其然,知其所以然。思路比结论更重要。