扫全库、索引表、缓存映射、单向函数、基因法——非分库键查询的五种折衷
《数据库架构与实践》第 10 篇:uid 分库后,uname 查询的五种方法。
用户中心是每一个公司必备的基础服务,用户注册、登录、信息查询与修改都离不开用户中心。
当用户中心单库数据量越来越大时,怎么办?
单库存不下,水平切分,用多库。
用什么业务属性水平切分?
主键uid。
如何进行数据路由?
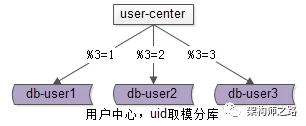
uid取模直接路由,例如:
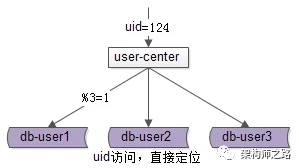
如上图所示,假设访问uid=124的数据,取模后能够直接路由db1。
那对于登录名uname上的查询怎么办?
扫全库法
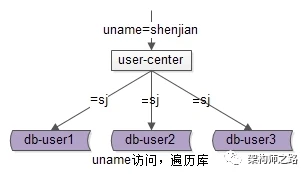
如上图所示,假设访问uname=shenjian的数据,由于不知道数据落在哪个库上,往往需要遍历所有库。
其潜在不足是:当分库数量多起来,性能会显著降低。
还有没有其他更加高效的方法呢?
常见的方案有以下几种。
索引表法
其设计思路是:uid能直接路由到库,uname不能直接路由到库,如果通过uname能查询到uid,则问题解决。
其具体步骤是:
1. 建立一个索引表,记录uname到uid的映射关系;
2. 用uname来访问时,先通过索引表查询到uid,再路由相应的库;
3. 索引表属性较少,可以容纳非常多数据,一般不需要分库;
4. 如果数据量过大,索引表可以通过uname来分库;
其潜在不足是:增加了一次数据库查询。
缓存映射法
其设计思路是:访问索引表性能较低,把映射关系放在缓存里性能更佳。
其具体步骤是:
1. uname先到cache中查询uid,再根据uid路由数据库;
2. 假设cache miss,降级为扫全库法获取uname对应的uid,放入cache;
3. uname到uid的映射关系不会变化,映射关系一旦放入缓存,不会更改,无需淘汰,缓存命中率超高;
4. 如果数据量过大,cache可以通过uname水平切分;
其潜在不足是:增加了一次cache查询。
uname生成uid
其设计思路是:无需远程查询,本地计算由uname直接得到uid。
其具体步骤是:
1. 在用户注册时,设计单向函数uname生成uid,uid=f(uname),按uid分库插入数据;
2. 用uname来访问时,先通过单向函数计算出uid,即uid=f(uname),再由uid路由到对应库;
如何设计单向函数,通过uname来生成uid?
最简单的单向函数是MD5:
1. 如果uid是128bit的,uid=MD5(uname);
2. 如果uid是64bit的,uid=MD5(uname)/2;
128bit折半的方法有很多,例如:取前一半,或者取后一半,或者前一半与后一半异或。
其潜在不足是:当用户量非常巨大的时候,有uid冲突的风险,需要一个补丁机制,来解决冲突问题。
基因法
其设计思路是:不用uname生成uid,从uname抽取“基因”,融入uid中。
什么是uname基因,如何将基因融入uid?
假设分8库,采用uid%8路由,其潜台词是,uid的最后3个bit决定这条数据落在哪个库上,这3个bit就是所谓的“基因”。
其具体步骤是:
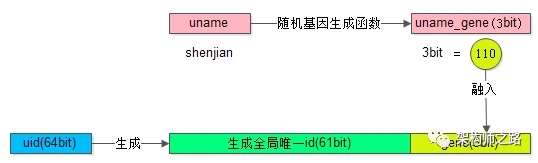
1. 在用户注册时,设计单向函数uname生成3bit基因,uname_gene=f(uname),如上图粉色部分;
2. 同时,使用ID生成器生成全局唯一uid的前61bit,如上图绿色部分;
3. 把前61bit与后3bit基因组合,生成64bit的最终uid,并用最终uid水平切分数据;
4.用uname来访问时,先通过单向函数由uname再次复原3bit基因,uname_gene=f(uname),通过uname_gene%8直接路由到库;
如何设计单向函数,通过uname来生成基因?
uname_gene=MD5(uname)再取最后3bit。
会不会导致数据分布不均匀?
不会,MD5具备完全随机性。
其潜在不足是:
1. uid一旦生成就无法更改,需要提前规划基因位数,例如:10年内最多分256库,提前预留8bit基因位;
2. 登录名不允许修改(该前提一般都满足);
3. uid确定以后,登录名以外的邮箱登录,手机号登录不能复用;
邮箱登录,手机号登录可使用通用方案2与方案3。
稍作总结
使用uid分库,uname查询有五种方法:
1. 扫全库法:遍历所有库;
2. 索引表法:数据库中记录uname到uid的映射关系;
3. 缓存映射法:缓存中记录uname到uid的映射关系;
4. uname单向函数生成uid:小概率冲突;
5. 基因法:uname单向函数生成基因融入uid,需要提前规划基因位数;
检验一下
检索练习 · 五种方法
使用 uid 分库后,uname 上的查询有哪五种方法?
检索练习 · 索引表法
索引表法的设计思路和潜在不足分别是什么?
检索练习 · 缓存映射法
缓存映射法中,cache miss 时怎么处理?为什么缓存命中率超高?
检索练习 · 基因法
分 8 库、采用 uid%8 路由时,「基因」指什么?用 uname 访问时如何路由?
分库后还有一类更狠的疑问:为什么数据库中间件干脆不支持 join?——第 11 篇《数据库中间件为什么不支持 join?》。
知其然,知其所以然。思路比结论更重要。