长度较短、访问频率较高的属性放主表——用缓冲池命中率读懂垂直拆分的原理
《数据库架构与实践》第 3 篇:数据库垂直拆分的依据与原理。
当数据库的数据量非常大时,水平切分和垂直拆分都降低数据量大小,提升数据库性能,有什么差别?
水平切分是指,以某个字段为依据(例如uid),按照一定规则(例如取模),将一个库(表)上的数据拆分到多个库(表)上,以降低单库(表)大小,达到提升性能的目的的数据库架构设计方法。
水平切分后,各个库(表)的特点是:
1. 每个库(表)的结构都一样;
2. 每个库(表)的数据都不一样,没有交集;
3. 所有库(表)的并集是全量数据;
垂直拆分是指,将一个属性较多,一行数据较大的表,将不同的属性拆分到不同的表中,以降低单库(表)大小,达到提升性能的数据库架构设计方法。
垂直切分后,各个库(表)的特点是:
1. 每个库(表)的结构都不一样;
2. 一般来说,每个库(表)的属性至少有一列交集,一般是主键;
3. 所有库(表)的并集是全量数据;
举个例子,用户表:
user(
    uid bigint,
    name varchar(16),
    pass varchar(16),
    age int,
    sex tinyint,
    flag tinyint,
    sign varchar(64),
    intro varchar(256)
…);
垂直拆分之后,可能变成两个这样的表:
user_base(
    uid bigint,
    name varchar(16),
    pass varchar(16),
    age int,
    sex tinyint,
    flag tinyint
…);

user_ext(
    uid bigint,
    sign varchar(64),
    intro varchar(256)
…);
垂直切分的依据是什么?
当一个表属性很多时,垂直拆分依据主要有几点:
1. 将长度较短,访问频率较高的属性尽量放在一个表里,这个表暂且称为主表;
2. 将字段较长,访问频率较低的属性尽量放在一个表里,这个表暂且称为扩展表;
3. 经常一起访问的属性,也可以放在一个表里;
为什么要这么这么拆分?
1. 数据库有自己的缓冲池buffer_pool,会将磁盘上的数据load到缓冲池里;
2. 缓冲池物理上以页page为单位,逻辑上以行row为单位,缓存数据;
3. 在内存有限,缓冲池大小固定的情况下,长度较短的row,能缓存更多数据;
4. 缓存高频的列column,能提升缓冲池命中率,减少磁盘IO;
举个例子:
1. 假设数据库内存buffer为1G,未拆分的user表1行数据大小为1k,那么只能缓存100w行数据;
2. 如果垂直拆分成user_base和user_ext,其中user_base访问频率高,1行大小为0.1k,就能缓存1000w行数据;
此时,访问磁盘的概率会大大降低,数据库访问的时延会大大降低,吞吐量会大大增加。
简单总结:
1. 海量数据高并发的数据库场景,垂直拆分能提升数据库性能;
2. 拆分核心依据是:将长度较短,访问频率较高的属性尽量放在主表里。
知其然,知其所以然。
思路比结论更重要。
检验一下
检索练习 · 两种拆分
水平切分之后,各个库(表)的特点是?
检索练习 · 拆分依据
垂直拆分时,「长度较短,访问频率较高的属性」应该放在?
检索练习 · 提速原理
垂直拆分能提升数据库性能,其缓冲池层面的原理是?
检索练习 · 数字例子
文中例子:1G 的 buffer,未拆分的 user 表 1 行 1k,能缓存多少行?垂直拆分后 user_base 1 行 0.1k,能缓存多少行?
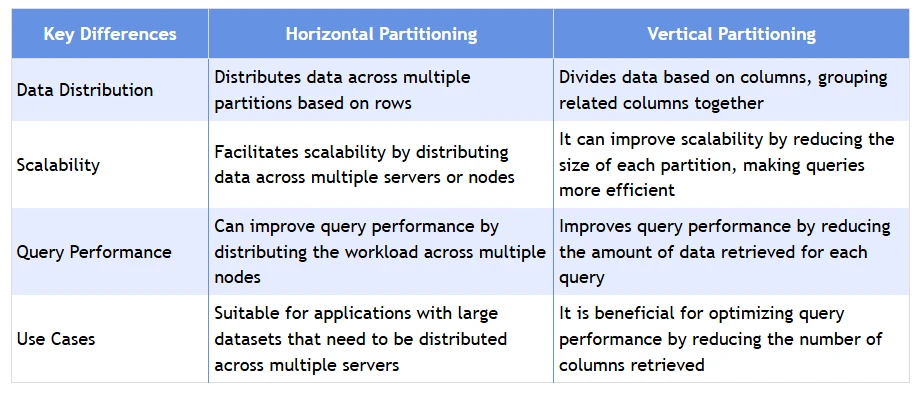
垂直拆分拆的是列,水平切分拆的是行——接下来四篇连讲水平切分,先从最简单的单 KEY 业务开始:第 4 篇《数据库水平切分:单 KEY 业务(用户中心)》。
知其然,知其所以然。思路比结论更重要。