主从防机器挂、备份防误删、延时从防恢复慢——数据库防灾架构的层层递进
《数据库内核原理》第 31 篇:数据库高可用与安全性架构设计。
数据库最基本的防灾怎么设计?
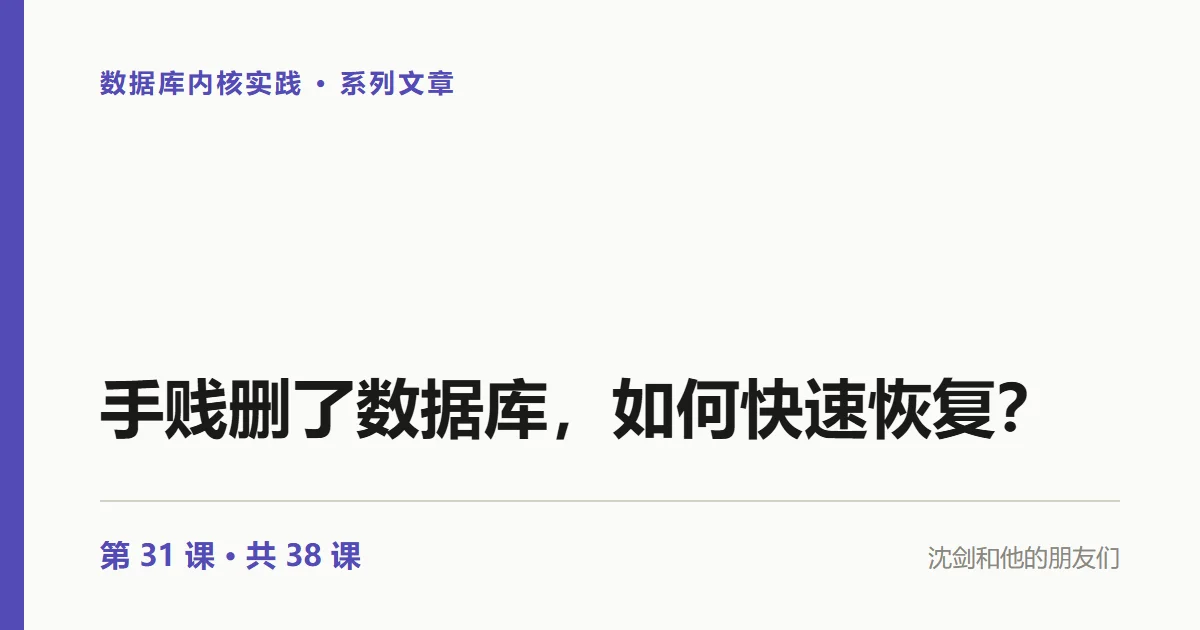
做主从架构:
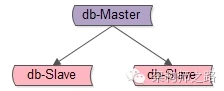
或者主主架构:
加上探活与故障转移,能够防:
1. 数据库挂掉;
2. 机器挂掉;
keepalived+Virtual IP。
有什么潜在问题?
不能防止人员恶意或者无意误删数据:一个不加where条件的delete下去,SQL会立刻同步到从库,一瞬间主从的所有数据都会被删除。
如何防止数据删除?
常见的安全策略是:定期全量与增量的备份。
例如:
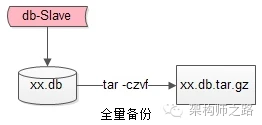
一周备份一次全量,一般是db文件。
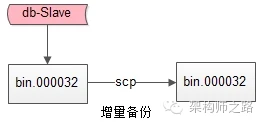
每天备份一次增量,一般是binlog。
如果误删数据,可以:
1. 应用最近一次的全量备份db;
2. 重放最近一次全量备份之后每天的增量binlog;
3. 重放最近一次增量备份之后,到删除操作之前的当天binlog;
为了保证方案的可靠性,需要定期进行恢复演练。
这个方案,还存在什么不足吗?
方案没问题,但恢复时间较长。
全量备份db+增量备份的binlog,一般都压缩保存在专门的备份服务器上,数据恢复的过程:
1. scp到本地;
2. tar解压;
3. 应用db;
4. 重放binlog;
往往需要几个小时的时间。
还能如何优化,缩短恢复时间?
可以使用1小时延时从的架构方案,能大大缩短误删数据的恢复时间。
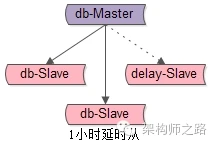
如上图所示,增加一个从库,这个从库不是实时与主库保持同步的,而是每隔1个小时同步一次主库,同步完之后立马断开1小时,这个从库会与主库保持1个小时的数据差距。
如果误删全库,只需要:
1. 应用1小时延时从;
2. 重放1小时延时从到删除操作之前当天的binlog;
这些binlog都在本地,且不用解压缩,恢复速度非常快。
这个方案,还存在什么不足吗?
极限情况下,在1小时延时从连上主库后,立刻发生了“误删数据”事故,则无法快速恢复。
还能如何优化,确保极限情况下方案的完备性?
可以使用【双份】1小时延时从。
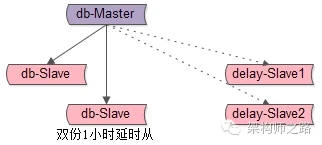
如上图所示,使用两个1小时延时从,他们连主库同步数据的时间“岔开半小时”,以确保极限情况下,至少有一个1小时延时从可用。
这样数据库的资源太浪费了吧?
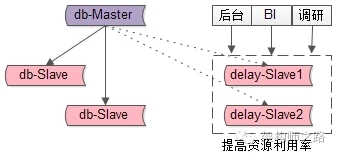
1小时延时从,可以对一些“允许延时”的业务提供读服务,例如:
(1)运营后台,产品后台查询;
(2)BI进行数据同步;
(3)RD进行数据抽样,调研;
以提高资源的利用率。
稍作总结
数据库防灾架构设计:
1. 防数据库与机器挂掉:主从or主主高可用;
2. 防数据误删:全量+增量备份架构;
3. 误删快速恢复:用1小时延时从架构;
4. 防小概率事件:双份1小时延时从架构;
5. 提高资源利用率:1小时延时从对“允许延时”的业务提供读服务;
检验一下
检索练习 · 高可用的盲区
主从/主主架构加探活与故障转移,能防什么、不能防什么?
检索练习 · 备份恢复步骤
「一周全量 + 每天增量」备份方案下,误删数据后的恢复步骤是?
检索练习 · 延时从
1 小时延时从为什么能大大缩短误删数据的恢复时间?
检索练习 · 双份延时从
为什么要用「双份」1 小时延时从,且同步时间岔开半小时?
备份与恢复是「兜底」,平时更常打交道的是 SQL 本身——一条查询到底走没走索引、扫了多少行?下一篇:explain 的 type 七种扫描方式。
知其然,知其所以然。思路比结论更重要。