用户建不了,InnoDB 自己会建——自适应哈希索引 AHI 的原理与适用场景
《数据库内核原理》第 12 篇:InnoDB 与自适应哈希索引。
经常有朋友问,MySQL的InnoDB到底支不支持哈希索引?
对于InnoDB的哈希索引,确切的应该这么说:
(1)InnoDB用户无法手动创建哈希索引,这一层上说,InnoDB确实不支持哈希索引;
(2)InnoDB会自调优(self-tuning),如果判定建立自适应哈希索引(Adaptive Hash Index, AHI),能够提升查询效率,InnoDB自己会建立相关哈希索引,这一层上说,InnoDB又是支持哈希索引的;
那什么是自适应哈希索引(Adaptive Hash Index, AHI)呢?原理又是怎样的呢?咱们先从一个例子开始。
不妨设有InnoDB数据表:
t(id PK, name KEY, sex, flag)
id是主键,name建了普通索引。
假设表中有四条记录:
1, shenjian, m, A
3, zhangsan, m, A
5, lisi, m, A
9, wangwu, f, B
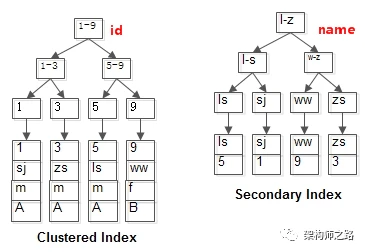
如上图,通过前序知识,容易知道InnoDB在主键id上会建立聚集索引(Clustered Index),叶子存储记录本身,在name上会建立普通索引(Secondary Index),叶子存储主键值。
发起主键id查询时,能够通过聚集索引,直接定位到行记录。
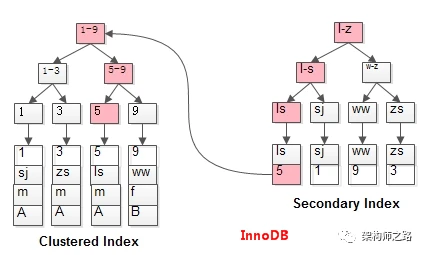
select * from t where name='ls';
发起普通索引查询时:
(1)会先从普通索引查询出主键(上图右边);
(2)再由主键,从聚集索引上二次遍历定位到记录(上图左边)。
不管聚集索引还是普通索引,记录定位的寻路路径(Search Path)都很长。
在MySQL运行的过程中,如果InnoDB发现,有很多SQL存在这类很长的寻路,并且有很多SQL会命中相同的页面(page),InnoDB会在自己的内存缓冲区(Buffer)里,开辟一块区域,建立自适应哈希索引AHI,以加速查询。
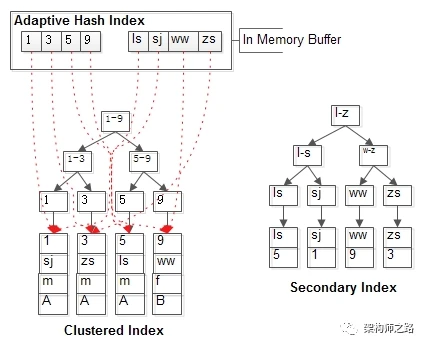
从这个层面上来说,InnoDB的自适应哈希索引,更像“索引的索引”,毕竟其目的是为了加速索引寻路。
既然是哈希,key是什么,value是什么?
key是索引键值(或者键值前缀)。
value是索引记录页面位置。
为啥叫“自适应”(adaptive)哈希索引?
系统自己判断“应该可以加速查询”而建立的,不需要用户手动建立,故称“自适应”。
系统会不会判断失误,是不是一定能加速?
不是一定能加速,有时候会误判。
当业务场景为下面几种情况时:
(1)很多单行记录查询(例如passport,用户中心等业务);
(2)索引范围查询(此时AHI可以快速定位首行记录);
(3)所有记录内存能放得下;
AHI往往是有效的。
任何脱离业务的技术方案,都是耍流氓。
当业务有大量like或者join,AHI的维护反而可能成为负担,降低系统效率,此时可以手动关闭AHI功能。
一个小知识点,希望对大家有帮助。
检验一下
检索练习 · 支持与否
MySQL 的 InnoDB 到底支不支持哈希索引?
检索练习 · key 与 value
自适应哈希索引(AHI)的 key 和 value 分别是什么?
检索练习 · 有效场景
哪种业务场景下 AHI 往往有效?
检索练习 · 何时关闭
业务有大量 like 或者 join 时,AHI 会怎样,该怎么处理?
AHI 是 InnoDB 自己玩的加速机制,下一篇回到你能控制的东西:自增主键。三类插入下自增值怎么分配,你都搞懂了吗?
知其然,知其所以然。思路比结论更重要。