简单插入、批量插入、混合插入——四组实验,直接贴真实执行结果
《数据库内核原理》第 13 篇:自增主键三类插入的测验答案。
《三类插入与自增键的关系》一文,基本解答了《自增键四道测验题》,仍有水友要求贴答案,原理都解释了,copy语句执行下,真的难么?
你们赢了,我还是贴一下执行结果。
自增键初始值测验
drop table t1;
create table t1(
    id int not null auto_increment,
    name varchar(10) unique,
    count int default 0,
    primary key(id),
    index(name)
)engine=innodb;

insert into t1(name) values("zhangsan"),("lisi"),("wangwu");
select * from t1;
请问,被插入的三条记录,id分别为:
A 0,1,2
B 1,2,3
C 以上都不对
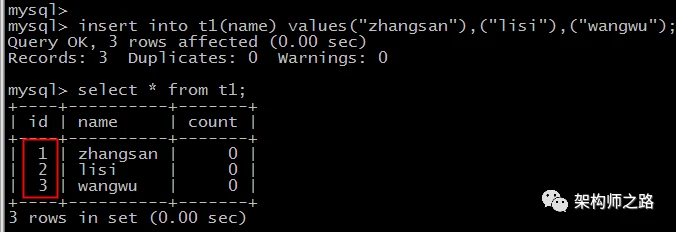
答案:B
自增键从1开始,该测验对应《三类插入与自增键的关系》中的简单插入(simple insert)。简单插入,能够提前知道被插入的行数,在处理自增键时,是最容易的。
批量插入测验
drop table t1,t2;
create table t1(
    id int not null auto_increment,
    name varchar(10) unique,
    count int default 0,
    primary key(id),
    index(name)
)engine=innodb;

create table t2(
    name varchar(10) unique
)engine=innodb;

insert into t2(name) values("x"),("y"),("z");

insert into t1(name) select name from t2;
select * from t1;
请问,上述insert…select…的执行结果是:
A 插入成功
B 插入失败,自增键报错
C 以上都不对
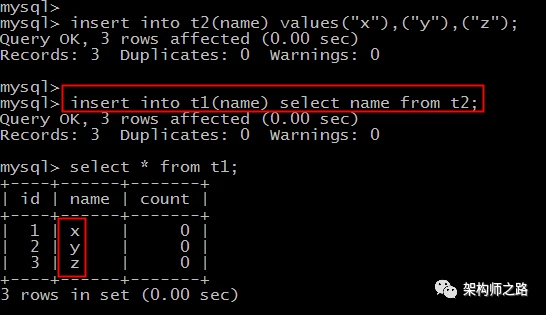
答案:A
插入成功,该测验对应《三类插入与自增键的关系》中的批量插入(bulk insert)。批量插入,不能提前知道被插入的行数,在处理自增键时,每插入一行,才会赋值新的自增值,在批量插入事务并发时,“可能”出现同一个事务的自增键不连续。
可以有优化机制,未来撰文。
混合插入测验
drop table t1;
create table t1(
    id int not null auto_increment,
    name varchar(10) unique,
    count int default 0,
    primary key(id),
    index(name)
)engine=innodb;

insert into t1(id, name) values(1, "shenjian");

insert into t1(id, name) values (111, "111"),(NULL, "abc"),(222, "222"),(NULL,"xyz");
select * from t1;
请问,最后一个insert语句,执行结束后id分别是:
A 1,2,3,111,222
B 1,111,112,222,223
C 插入失败,自增键报错
D 以上都不对
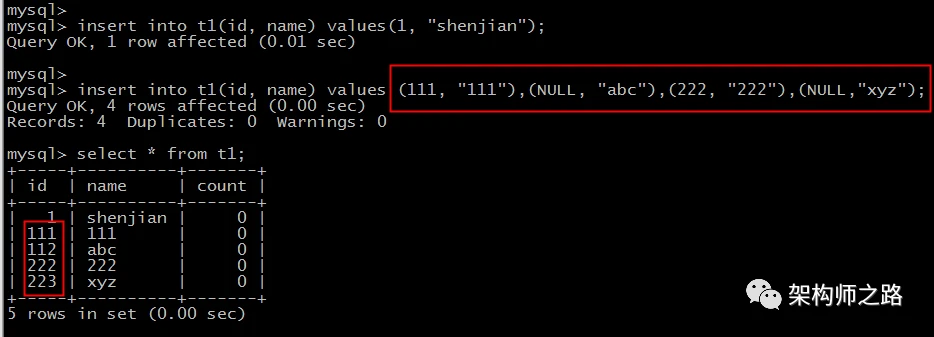
答案:B
插入成功,自增键每次从最大值后面开始新增,该测验对应《三类插入与自增键的关系》中的混合插入(mixed-mode insert)。有些行插入时指定了自增键,无需数据库生成;有些行插入时未指定自增键(NULL),需要数据库生成。
insert … on duplicate key测验
接着实验三,继续执行以下语句:
insert into t1(name)values("shenjian"),("aaa"),("bbb")

on duplicate key update count=100;

select * from t1;
请问,最后一个insert语句,执行结束后id分别是:
A 1,2,3,111,222,223,224,225
B 1,111,112,222,223,224,225,226
C 1,111,112,222,223,224,225
D 1,111,112,222,223,225,226
E 以上都不对
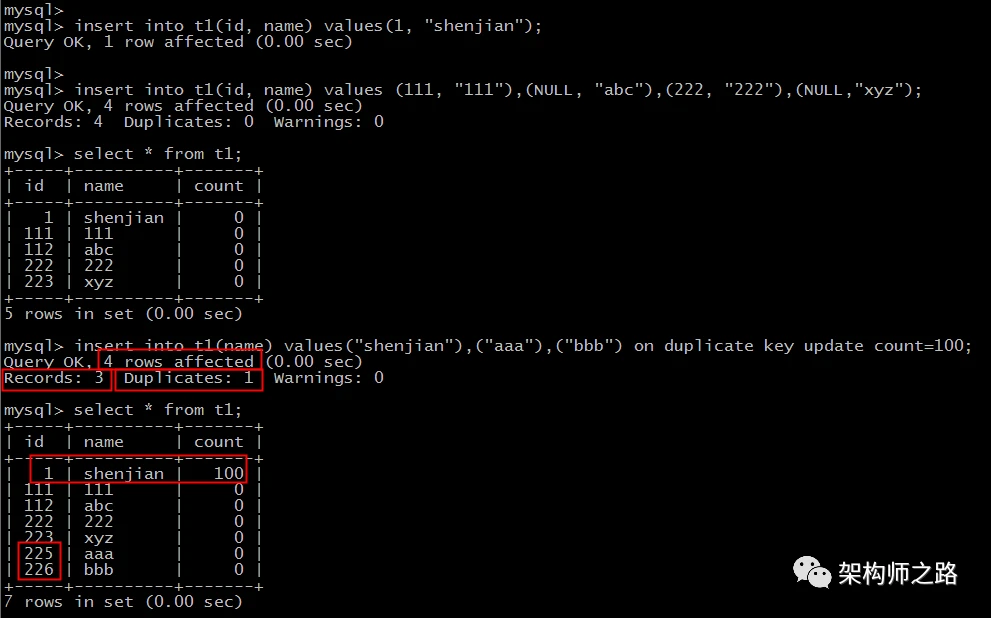
答案:D
该测验也对应《三类插入与自增键的关系》中的混合插入(mixed-mode insert)。有些行插入实际上是修改,无需数据库生成自增键;有些行插入实际上就是插入,需要数据库生成自增键。
insert … on duplicate key update … 这种情况是最最复杂的,它可能导致,系统生成的自增值,在更新阶段用不上。
官网原文是:
an INSERT followed by a UPDATE, where the allocated value for the AUTO_INCREMENT column may or may not be used during the update phase.
伸手党们,这下满足了吧?都答对了么。
MySQL版本为MySQL5.6。
相关文章:
第 24 篇《InnoDB 缓冲池 buffer pool:LRU 的两次改良》
第 25 篇《InnoDB 写缓冲 change buffer:写请求怎么免磁盘 IO?》
作业题:
insert into t1(name)values("zhangsan"),("lisi"),("wangwu");
这类简单插入,当有并发事务执行时,自增键仍能保证连续性,是如何做到的?
A: 行粒度加锁,实施互斥
B: 表粒度加锁,实施互斥
C: 全局自增键单例,实施互斥
D: SQL语句粒度加锁,实施互斥
E: 事务粒度加锁,实施互斥
检验一下
检索练习 · 自增键初始值
新建表的自增键从几开始分配?
检索练习 · 批量插入
insert … select … 这类批量插入,自增键的处理特点是?
检索练习 · 混合插入
已有 id=1 的记录,再执行 insert values (111,”111″),(NULL,”abc”),(222,”222″),(NULL,”xyz”),最终 id 是?
检索练习 · on duplicate key
insert … on duplicate key update … 为什么是最最复杂的情况?
三类插入弄懂了,还有更细的坑:delete 之后自增计数会归零吗?手动插入 0 或 NULL 会发生什么?第 14 篇:MySQL 自增 ID 的四个易错点。
知其然,知其所以然。思路比结论更重要。