FP8 通用矩阵乘法库:300 行优美的代码,简洁、高效、高精度
《DeepSeek 原理与实践》第 11 篇:deepseek 极限潜能 – DeepGEMM。
deepseek开源周,继DeepEP之后,开源了第三弹DeepGEMM。
今天简单来说说:
1. 吃瓜:DeepGEMM是干嘛的?
2. 技术:DeepGEMM是怎么做到的?
3. 普通人有什么用:对写提示词有什么启示?
DeepGEMM是干嘛的?
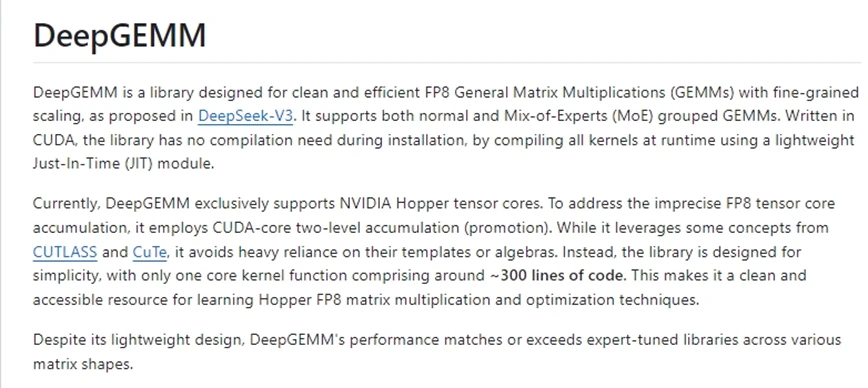
DeepGEMM,General Matrix Multiplication,一个FP8通用矩阵乘法库(library)。
画外音,FP8:8-bit Floating Point,8位浮点格式。
关于FP8通用矩阵乘法
一个矩阵乘法的优化而已,写了这么多年代码都没用过矩阵乘法,值得这么吹流弊吗?
额,我竟无言以对。
矩阵乘法是现代AI计算的基石。
1. 矩阵是数据表示的核心工具:神经网络中的权重,特征,参数传递等都使用矩阵表示;
2. 矩阵乘法占大模型中90%的计算量:Transformer基操QKV运算,卷积计算,分层全连接计算等;
3. 硬件优化的核心目标就是矩阵乘法计算;
传统AI的矩阵乘法怎么算?
传统一般使用NVIDIA开源的CUDA C++模板库CUTLASS。
传统方法通常采用FP16/FP32,存在一些潜在的不足:
1. 占显存资源:FP32占显存是FP8的4倍;
2. 资源利用率低:强制要求矩阵为2次幂尺寸(例如:128*128),容易出现显存碎片;
3. 不支持MOE模型的分组矩阵计算;
4. 部署复杂度高:需要编译,需要配置;
那为什么之前不直接采用FP8呢?
FP8虽然占用资源少,资源利用率高,但会带来精度损失。
这个问题程序员最好理解。
高精度乘法:1.2 * 3.4 = 4.08
如果直接降低精度,用整数表示浮点数,变为1 * 3 = 3,精度损失是无法接受的。
那有没有弥补精度不足的问题?
我们可以对浮点数进行整数化编码处理:
步骤一:1.2用(12, 1)表示,其中1是小数位数;
步骤二:3.4用(34, 1)表示;
步骤三:1.2 * 3.4 = (12, 1) * (34, 1) = (12*34, 1+1) = (408, 2)
如此一来,就没有精度损失啦。
当然,矩阵乘法的精度补偿比这个复杂,其核心思路是:使用低精度乘法矩阵快速计算,高精度加法补足。
结论就是:deepseek使用FP8就能完成FP16/FP32的计算,降低显存占用+提高显存利用率的同时,仍然能够保持高精度。
DeepGEMM的特点
Git介绍中对DeepGEMM有三个关键形容词:
– 简洁(clean)
– 高效(efficient)
– 高精度(fine-grained scaling)
为什么说DeepGEMM简洁?
- 核心代码300行,而CUTLASS数千行;
- 零依赖(除CUDA),无需预编译,无需复杂环境配置;
- 注释清晰,便于学习与二次开发;
画外音:我看了一下,调整数据分块策略,只需要修改10-20行代码。
为什么说DeepGEMM高效?
这是FP8对比FP16/FP32的天然优势,相比CUTLASS:
- 显存占用下降50%+;
- MOE推理延时下降60%+;
- 计算密度(TFLOPS)提升了270%+;
为什么说DeepGEMM高精度?
采用FP8矩阵乘法加速计算,BF16累加修正精度的方法,平衡了速度与精度。
除此之外,DeepGEMM还有不少特色:
- 针对MOE优化,支持MOE分组矩阵乘法;
- 针对硬件加速;
- 动态编译JIT:运行时根据矩阵大小与硬件条件优化;
- 矩阵灵活尺寸对齐(例如:可以支持112*128矩阵);
上面种种,DeepGEMM本次最大的创新,我认为是:FP8优化,JIT优化,以及MOE优化。
DeepGEMM是怎么做到的?
信息密度太大,头疼,有点学不过来了,感兴趣的同学去官网看吧,我Copy一下git的信息:
1. Persistent warp-specialization
2. Hopper TMA features
3. A unified and optimized block scheduler
4. Fully JIT design
5. Unaligned block sizes
6. FFMA SASS interleaving
7. Common detail optimizations
画外音:其实你也不想知道这些how?
了解GEMM对普通人写提示词有什么启示?
没有启示,这东西和提示词没关系。
结尾
对于DeepGEMM,我的思考是:
- 之前各大玩家都卷硬件,而忽略了软件的优化;
- 僵化思维真的很要命,一直以来都是FP16/FP32,大家也都用CUTLASS,它就一定是最优吗?
- 写代码,搞架构,少即是多:多写这类300行优美的代码,而不要在垃圾公司堆shi山;
先睡了,共勉!
画外音:球球deepseek,明天不要开源新东西了。
检验一下
想深挖一层,直接去官方仓库翻代码:github.com/deepseek-ai/DeepGEMM,可参考。
本篇「DeepGEMM 是怎么做到的」一节里那 7 条看不懂的 how(Persistent warp-specialization、Hopper TMA、FFMA SASS interleaving……),仓库里就是全部答案,核心代码只有 300 行,适合真读。
通讯库有了,矩阵乘法也快了,可 GPU 在训练时还有空转的「泡泡」——第 12 篇,看 DualPipe 怎么用双向管道把流水线填满,作者名单里还有个大人物。
知其然,知其所以然。思路比结论更重要。