2013 年调研笔记:阿里开源的 MySQL 中间件,支持什么、不支持什么
《数据库架构与实践》第 12 篇:cobar 调研笔记。
13年底负责数据库中间件设计时的调研笔记,拿出来和大家分享,轻拍。文章很长,可提前收藏,转发。
cobar是什么
阿里开源的mysql的中间件服务
使用mysql协议
对上游,cobar就是传统mysql数据库
对上游,它屏蔽后端分布式mysql集群
数据库中间件有基于服务端的,也有基于客户端的,cobar属于前者。
cobar应用场景举例
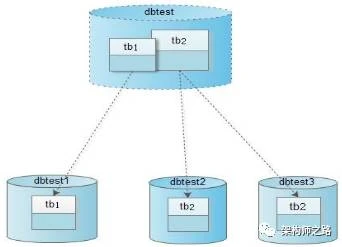
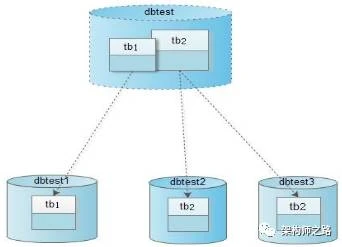
逻辑上:
数据库dbtest(虚拟的)
表tb1和tb2
物理上:
tb1表的数据在dbtest1(物理的)的tb1上
tb2表的一部分数据在dbtest2(物理的)的tb2上,另外一部分在dbtest3(物理的)的tb2上
cobar使用方式
命令行:连dbtest虚拟库
JDBC:也是连dbtest虚拟库
查看db:
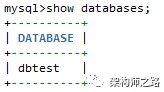
可看到dbtest1、dbtest2、dbtest3对用户透明。
查看table:
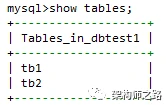
可看到有tb1和tb2两张表。
插入一些数据,对用户而言,后端的分布式mysql是透明的:
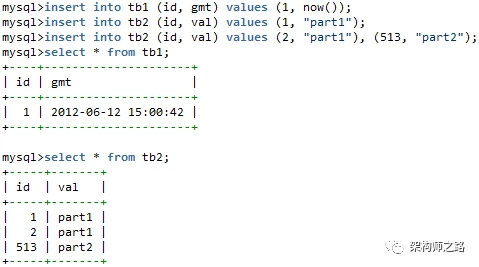
对tb1,数据实际上存在dbtest1的tb1中
对tb2,数据实际上存储在dbtest2和dbtest3的tb2中
从其官网上看,自12年12月之后,cobar就没有再更新过,官方微博也非常不活跃,不清楚现在它在阿里的使用情况,知道的同学请说一说。
cobar不支持什么
不支持跨库join,分页,排序,子查询
set语句会被忽略(事务和字符集设置除外)
如果分库,insert必须包含partition key(否则麻烦大了)
如果分库,partition key不能被update
不支持读写分离
不支持存储过程
如果使用JDBC,rewriteBatchedStatements,useServerPrepStmts,BLOB, BINARY, VARBINARY字段不能使用setBlob()或setBinaryStream()
cobar支持什么
分布式数据库:通过分库实现
支持一张表放到不同的库
支持不同的表放入不同的库
需要注意:不支持将test拆分成test_1,test_2,test_3并放入同一个库中这样的拆分方式。
后者正是360的atlas的做法(atlas只支持单实例单库分表)。
HA:通过到mysql的心跳实现
主机挂了会自动切换回备机,但主机恢复,需要手动切回
只检测主备异常,不关心主备数据同步(需要dba手动配)
需要注意,cobar是需要用户自己来实现负载均衡的,方式有三种:
自己使用软件例如LVS
自己使用硬件例如F5
cobar提供了命令获取集群信息,用户可以根据这些信息做负载均衡;当然,淘宝已经实现了一个具有负载均衡功能的cobar客户端产品-cobar.driver
SQL路由
在分库的情况下,cobar会从sql中提取partition key列,来判断SQL被路由到哪一个分库进行执行;如果没有带partition key,则会将SQL分发到所有分库执行。
示例
tb1(id INT)
假设以id切分数据,后端分了N个库:
insert into tb1 values(1);
=> N个库都会执行插入,因为没有带partition key;
insert into tb1(id) values(1);
=> 只会路由到1个库,带了partition key;
update tb1 set id=2 where id=1;
=> 不支持,不能修改partition key;
SQL带上partition key对cobar来说,非常非常重要,并且partition key不支持修改(修改了库就不对了哟)。
cobar不允许在同一个连接中切换库。
数据库连接和库是绑定关系。
不建议通过cobar来执行DDL语句。
所以建库,建索引什么的,还是直连mysql自己搞吧。
COBAR自定义语句
查询cobar节点的状态
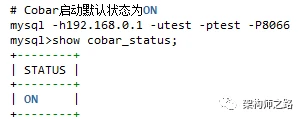
cobar允许管理员通过管理命令上线和下线cobar节点。
查询cobar集群的状态
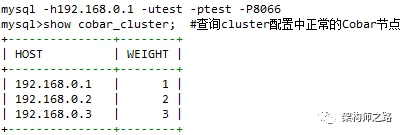
被定义在一个cobar集群中的cobar节点之间都会发送心跳,所谓的心跳就是上面提到的show cobar_status; 这样的话,就为每一个cobar节点提供了知道同一个集群内的所有cobar信息的机会。当然,被下线,或者心跳超时的cobar节点的信息不会被显示出来。
查询SQL语句的路由情况
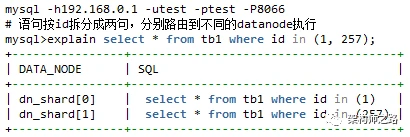
SQL语句前加上explain即可知道SQL语句的路由情况。
事务的支持
cobar对单库保持事务的强一致性。
对分库保持事务的弱一致性。
分库后事务提交包含两个阶段:
执行阶段:SQL按照规则被路由到多个分库,此时发生错误,还能回滚
提交阶段:提交阶段出错,无法正确回滚
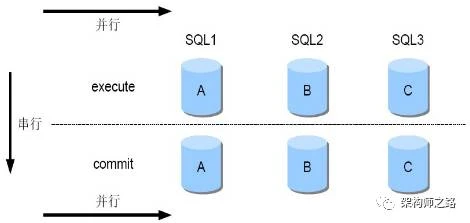
两个阶段之间,执行与提交串行处理,阶段内部各个分库并行处理。
额,基本就是不支持分布式事务。
cobar系统架构
系统模块图
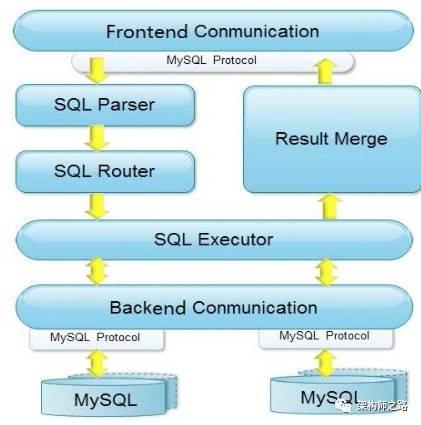
从模块图来看,cobar的结构还是挺清晰的:
前端对上游的连接池
后端对下游mysql的连接池
对每一个请求,会经过:
SQL分析
SQL路由
SQL执行
投递给后端mysql
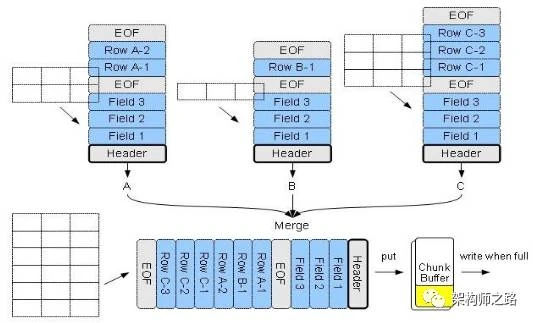
对每一个响应,需要做结果合并
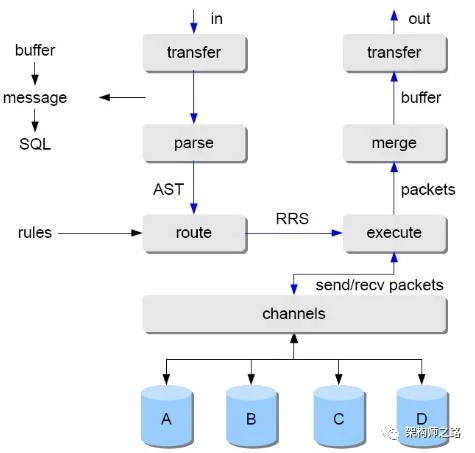
数据流图
数据流图和上述模块图对应:
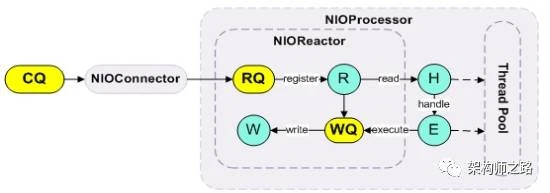
网络模型
采用异步网络模型:
结果合并
会把多个物理库的结果集合并,再返回给上游:
cobar路由算法
partition key是int时
好办,直接取模
partition key是string时
f(string) = hash(string) % 1024
假设分4个库:
哈希结果0-255 -> 库1
哈希结果256-511 -> 库2
哈希结果512-767 -> 库3
哈希结果768-1023 -> 库4
如何扩容:
哈希结果0-255 -> 库1
拆分后:
哈希结果0-127 -> 库1.1
哈希结果128-255 -> 库1.2
数据非均匀分布路由:
哈希结果0-511(512范围) -> 库1
哈希结果512-767(256范围) -> 库2
哈希结果768-895(128范围) -> 库3
哈希结果896-1023(128范围) -> 库4
cobar对于SQL的转发
带partition key单记录查询
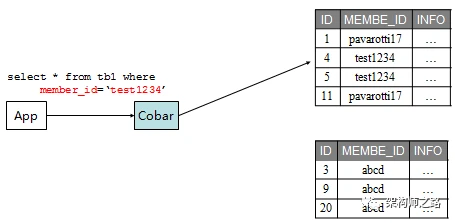
直接根据partition key路由。
带partition key的IN查询
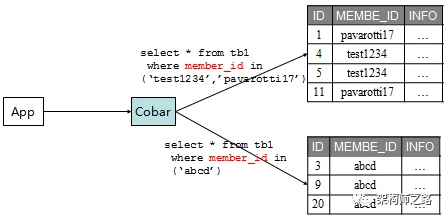
将IN进行拆分,请求发到对应多个分库,然后将结果集合并。
不带partition key的where查询
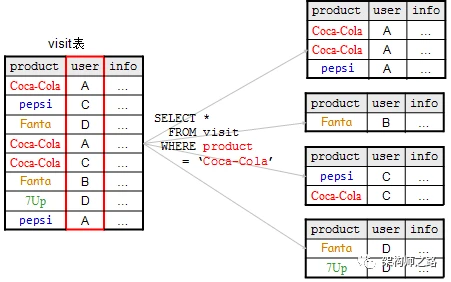
假设partition key是user字段,在product字段上的where查询,会将请求广播到所有分库,然后将结果集合并。
二维partition key
一张表的多个字段同时作为定位库的拆分字段,仍以上图的visit(product, user, info)为例,可以以product和user两个字段来定位库。
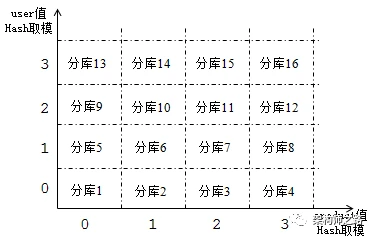
横坐标product属性取hash,纵坐标user属性取hash。
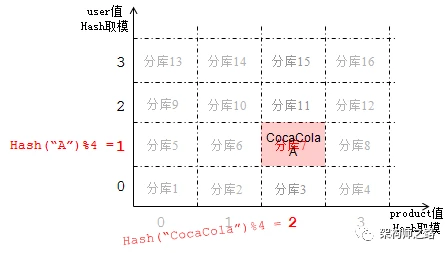
SELECT * FROM visit WHERE product=‘ColaCola’ AND user=‘A’
对于上述业务需求,同时带有两个列作为查询条件,可以直接定位到库7。
但是,此时如果只有其中的一个字段作为查询条件,反而得查询多个库,再做聚合:
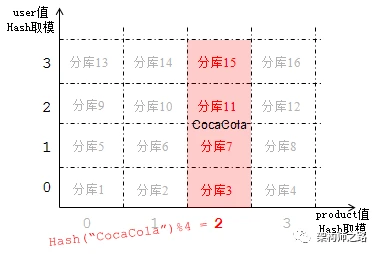
SELECT * FROM visit WHERE product=‘ColaCola’
对于上述业务需求,就必须查询库3,7,11,15了。
不懂为什么要按照双key来做路由,单key路由,对于双key的查询,也没有增加多少数据扫描量啊,加入双key反而使得某些情况下策略复杂了,带来的收益也不高。
小结
对的,对于where,cobar就是这样的处理方式:
根据字段的一致性hash分布数据
多维拆分
根据where中的partition key分发查询
SQL语句变换,分发至各个分库执行,对结果进行合并
cobar的高级特性
JOIN有限的处理
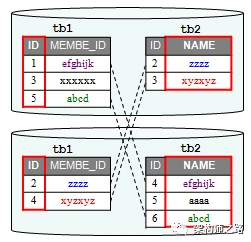
如上,两个表都进行了分库,JOIN需求如下:
SELECT * FROM tb1 INNER JOIN tb2
    ON tb1.MEMBER_ID=tb2.NAME
结果集理应如下:
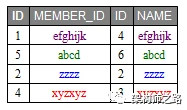
方案一:迭代查询
FOR row1 IN select * FROM tb1{
    ADD(
        SELECT* FROM tb2 WHERE
            tb2.name = row1.member_id
    )TO RESULT
}
我去,外层循环是对tb1中的所有记录,在tb2来一遍扫描,tb1数据量大的情况下,这哪里受得了?
方案二:跨库索引
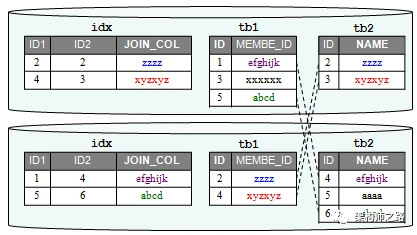
对于tb1和tb2存在的潜在JOIN需求,对JOIN列建立跨库索引。
直接JOIN查询:建立了跨库索引后,对于JOIN的直接查询,就是idx索引表内的数据的合并就是结果
JOIN后带WHERE条件:
SELECT * FROM tb1 INNER JOIN tb2
ON tb1.MEMBER_ID=tb2.NAME
      WHERE tb1.id=5
此时需要改写SQL语句,直接在索引表上进行查询:
SELECT * FROM idx WHERE id1=5
此处需要注意:
索引表的partition key:WHERE条件所在表的partition key,作为索引表的partition key
索引必须包含参与JOIN相关表的主键,JOIN字段,包含WHERE条件的字段
索引的更新:需要分布式事务的支持
GROUP BY的处理
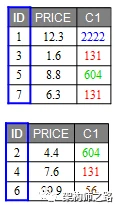
以上表为例,partition key是ID,要在C1上进行GROUP BY操作:
SELECT SUM(price) FROM tb1 GROUP BY c1;
改写SQL语句,先在各个分库上GROUP BY一次,并将sum计算出来:
SELECT SUM(price), c1 FROM tb1 GROUP BY c1 ORDER BY c1;
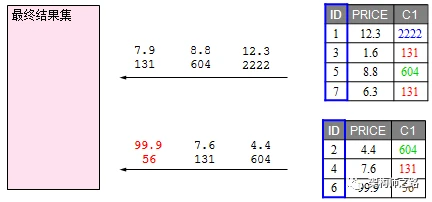
各分库进行GROUP BY + ORDER BY + sum之后,根据排序后的c1及对应sum结果,归并一遍后即得到最终结果。
小结
对于复杂语句,可以这样处理:
对于JOIN,可以迭代查询,或者使用分布式索引
对于GROUP BY,需要增加查询列,以及ORDER BY
13年底的调研笔记,文中的“画外音”是我当时的批注,希望能让大家对cobar能有一个初步的认识,有疑问之处,欢迎交流。
检验一下
检索练习 · cobar 是什么
cobar 是一个什么样的数据库中间件?
检索练习 · 不支持什么
下列哪组是 cobar 不支持(或受限)的能力?
检索练习 · SQL 路由
分库情况下,cobar 如何决定一条 SQL 路由到哪里执行?
检索练习 · GROUP BY 处理
cobar 对跨库 GROUP BY(如 SELECT SUM(price) FROM tb1 GROUP BY c1)是怎么处理的?
看完服务端中间件,再看一个客户端路线的——第 13 篇《数据库中间件 TDDL 调研笔记》。
知其然,知其所以然。思路比结论更重要。