数据管道找 MQ,数据共管要拆分,数据访问走 RPC——三种场景,一个结论
《缓存架构与实践》第 13 篇:为什么不要用缓存传递数据。
朋友说他有一个巧妙架构方案,服务之间通过缓存传递数据:
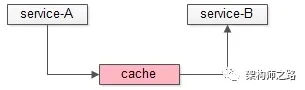
如上图:
1. service-A将数据放入cache;
2. service-B从cache里读取数据;
朋友问我,这种架构设计好还是不好?
我旗帜鲜明的反对“服务之间通过缓存传递数据”,下面三种场景,这种设计都不适合。
数据管道场景,MQ比cache更加适合
如果只是单纯的将cache作为两个服务数据通讯的管道,service-A生产数据,service-B(当然,可能有service-C/service-D等)订阅数据,MQ比cache更加合适:
1. MQ是互联网常见的逻辑解耦,物理解耦组件,支持1对1,1对多各种模式,非常成熟的数据通道;
2. 而cache反而会将service-A/B/C/D耦合在一起,大家要彼此协同约定key的格式,ip地址等;
3. MQ能够支持push,而cache只能拉取,不实时,有时延;
4. MQ能支持数据落地,cache具备将数据存在内存里,具有“易失”性,当然,有些cache支持落地,但互联网技术选型的原则是,让专业的软件干专业的事情:nginx做反向代理,db做固化,cache做缓存,mq做通道;
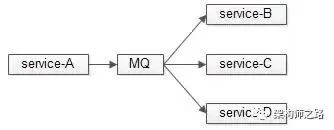
综上,数据管道场景,MQ比cache更加适合。
数据共管场景,两个(多个)service同时读写一个cache实例会导致耦合
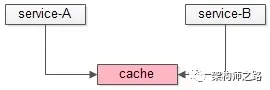
如果不是数据管道,是两个(多个)service对一个cache进行数据共管,同时读写,也是不推荐的,这些service会因为这个cache耦合在一起:
1. 大家要彼此协同约定key的格式,ip地址等,耦合;
2. 约定好同一个key,可能会产生数据覆盖,导致数据不一致;
3. 不同服务业务模式,数据量,并发量不一样,会因为一个cache相互影响;
例如:
service-A数据量大,占用了cache的绝大部分内存,会导致service-B的热数据全部被挤出cache,导致cache失效。
又例如:
service-A并发量高,占用了cache的绝大部分连接,会导致service-B拿不到cache的连接,从而服务异常。
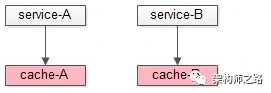
综上,数据共管场景,多个service耦合在一个cache实例里,也是不推荐的,需要垂直拆分,实例解耦。
数据访问场景,两个(多个)service有读写一份数据的需求
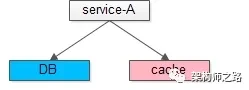
根据服务化的原则,数据是私有的(本质也是解耦):
1. service层会向数据的需求方屏蔽下层存储引擎,分库,cache的复杂性;
2. 任何需求方不能绕过service读写其后端的数据;
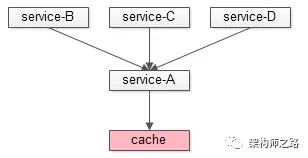
假设有其他service要有数据获取的需求,应该通过service提供的RPC接口来访问,而不是直接读写后端的数据,无论是cache还是db。
简单总结
不管哪种场景,服务之间都不要使用缓存来传递数据:
1. 数据管道场景:MQ比cache更合适;
2. 数据共管场景:多个服务不应该共用一个cache实例,应该垂直拆分解耦;
3. 数据访问场景:服务化架构,不应该绕过service读取其后端的cache/db,而应该通过RPC接口访问;
检验一下
误用讲完了,接下来看看缓存的极限玩法——第 14 篇(全系列最后一篇):每秒 10W 并发的无锁缓存,是怎么做到的?
知其然,知其所以然。思路比结论更重要。